
کین لوکاس، آنگوس لینچ، لونا تونگ، لوک چامپاین، زیگی استرازنیکیس، دینو دیستفانو، هارشیکا آگراوال
اویاتار بن اشِر، ایوا هاوِل، سامی جوهر، کریس رُلف، نیکولای زلدوویچ
نیکولای کارلینی، راجاشری آگراوال، جیسون گراس
اکثر نرمافزارها سرشار از باگ هستند و هوش مصنوعی اکنون به راحتی میتواند آنها را یافته و سوءاستفاده کند. دفاعهای استاندارد در برابر حملات سایبری دیگر کافی نیستند: ما به روشهایی نیاز داریم که ثابت کنند کد از باگ پاک است. صحتسنجی رسمی نرمافزار میتواند این تضمین را فراهم کند، اما به طور تاریخی نیازمند سالها تلاش متخصصان بوده و آن را برای اکثر پروژههای دنیای واقعی غیرعملی ساخته است. با این حال، در یک همکاری با شرکت تئورم، ما نشان میدهیم که این دیگر چنین نیست: مدلهای زبانی بزرگ (LLMs) اکنون میتوانند اثباتهای رسمی را در مقیاس بزرگ تولید کنند و جریانهای کاری جدید توسعه نرمافزار را ممکن سازند که شامل تضمینهای امنیتی اثباتشده باشد. با استفاده از کلود، ما ویژگیهای امنیتی را در سطح کد اسمبلر (RISC-V) در بیش از ۱۰۰ کتابخانه نرمافزاری متنباز واقعی اثبات کردیم. تا جایی که ما میدانیم، این نخستین تلاش گسترده برای استفاده از هوش مصنوعی جهت اعمال صحتسنجی رسمی بر نرمافزارهای تولیدی در سطح کد اسمبلر است. حین نوشتن اثباتها، کلود همچنین باگهایی را کشف کرد که با وجود تریلیونها اجرای آزمایش، سالها از تشخیص پنهان مانده بودند. با ادامه بهبود قابلیتهای مدلها، انتظار داریم صحتسنجی رسمی به بخشی ضروری از توسعه نرمافزار امن تبدیل شود.
مقدمه
حتی نرمافزارهای بالغ و به شدت آزمایششده نیز حاوی باگ هستند و مدلهای زبانی بزرگ روزبهروز در یافتن آنها ماهرتر میشوند. هسته لینوکس—یکی از آزمایششدهترین قطعات نرمافزار امروز که روی میلیاردها دستگاه در سراسر جهان استقرار یافته است—اخیراً بیش از ۱۰۰۰ آسیبپذیری در آن افشا شده است. با اینکه مدلهای مرزی (Frontier models) بیشتر قادر به زنجیره کردن باگهای ظاهراً بیضرر به اکسپلویتهای بحرانی هستند، ما به تکنیکهایی نیاز داریم که بتوانند این باگها را قبل از سوءاستفاده در محیط واقعی شناسایی و اصلاح کنند.
در حالت ایدهآل، چنین تکنیکهایی میتوانند همه باگها را یافته و وصله کنند و سپس برخی اثبات ارائه دهند که دیگر باگ دیگری یافت نمیشود. صحتسنجی رسمی یکی از راههای انجام این کار است. در صحتسنجی رسمی، توسعهدهندگان کد خود را به یک مدل ریاضی ترجمه میکنند، سپس سعی میکنند اثبات کنند که این مدل همیشه از مجموعهای تعریفشده از قوانین امنیتی پیروی میکند. اگر آنها در اثبات این موضوع شکست بخورند، به معنای وجود احتمال یک باگ در کد است که قانونی را نقض میکند و ماهیت شکست نشان میدهد که باگ چه چیزی ممکن است باشد. تکرار این فرآیند (پس از حذف علت شکست در هر بار) در نهایت منجر به اثباتی میشود که نشان میدهد کد عاری از هرگونه باگی است که آن قوانین را نقض کند.
با این حال، صحتسنجی رسمی آسان نیست. اثباتها میتوانند چندین برابر بزرگتر از کد اصلی باشند و نوشتن آنها نیازمند تلاش قابل توجه و مهارتهای تخصصی بسیار خاص است. برای مثال، پیادهسازی هسته سیستمعامل seL4 دو نفر-سال زمان برد، اما ۲۰ نفر-سال برای صحتسنجی رسمی آن لازم بود. بر همین اساس، صحتسنجی رسمی تنها در کاربردهای حیاتی واقعاً حساس، مانند کد اویونیک ایرباس عملی بوده است.
اما مدلهای زبانی بزرگ این کار را بسیار آسانتر کردهاند. مدلهای مرزی اکنون میتوانند به طور کاملاً خودکار اثباتهای صحت برای نرمافزارهای دنیای واقعی تولید کنند. برای نشان دادن این موضوع، از کلود خواستیم تا ویژگیهای امنیتی مفید را در ۱۲۳ کتابخانه متنباز اثبات کند، از جمله نشان دادن اینکه برخی از مصنوعات اجرایی آنها تحت شرایط خاصی هرگز کرش نمیکنند. به طور مشخص، کلود اثبات کرد که این برنامهها همیشه به طور طبیعی خارج میشوند بدون اینکه خطاهای ایمنی حافظه را تحریک کنند یا ادعاهایی (Assertions) را نقض نمایند، برای هر ورودی کمتر از ۶۴ مگابایت و هر پاسخ سیستمعامل لینوکس و چیدمان حافظه مدلسازیشده، تحت برخی فرضیات (یعنی اینکه برنامه به عنوان یک باینری استاتیک تکرشتهای با بودجه حافظه ثابت روی پردازنده RISC-V1 با سیستمعامل لینوکس اجرا میشود). این هنوز فاصله زیادی تا رفع همه باگهای ممکن دارد، اما ما را بسیار نزدیکتر از قبل کرده و نقشه راهی به سوی آن هدف ارائه میدهد.
ما زیرمجموعهای از این اثباتها را منتشر میکنیم تا هر کسی بتواند آنها را بررسی و استفاده مجدد کند، همراه با معانی اسمبلر RISC-V و سیستمعامل. شرکت تئورم، همکار ما در این پروژه، همچنین پیشنهاد میکند همان خط لوله را برای سایر پروژههای متنباز اجرا کند و یک مهارت کلود (Claude skill) را منتشر میکند تا به توسعهدهندگان کمک کند شروع به صحتسنجی کد خود کنند.
صحتسنجی رسمی حوزهای گسترده با متدهای متعدد است. در ادامه، ما کاوشهای اولیه خود را با استفاده از سایر روشهای صحتسنجی رسمی برای تسریع سایر وظایف امنیتی یا توسعه نرمافزار توصیف میکنیم، مانند ارزیابی امنیت الگوریتم فشردهسازی zlib، اثبات همارزی رفتاری یک مفسر پایتون نوشتهشده در زبان Rust، و ریشهیابی باگهای قدیمی در نرمافزارهای حیاتی.
راه پیش رو برای صحتسنجی رسمی امیدوارکننده است. هزینه نوشتن اثباتها با هوشمندتر شدن مدلها کاهش مییابد. علاوه بر این، با رسمیتر شدن کدهای بیشتر و استانداردتر شدن روشهای دستیابی به تضمینهای امنیتی، توانایی استفاده مجدد یا تغییر اثباتها در بین پایگاههای کد، هزینه را تعدیل خواهد کرد. ما همه توسعهدهندگان را تشویق میکنیم که صحتسنجی رسمی با LLMها را کاوش کنند—به ویژه کسانی که قبلاً با مدلهای ضعیفتر امتحان کرده و نتیجه نگرفته بودند.
در ادامه این پست، ما آزمایشهای صحتسنجی رسمی خود را با جزئیات بیشتری پوشش میدهیم.
تبدیل تستها به اثباتها
برای اثبات صحیح بودن یک قطعه نرمافزار، ابتدا باید بیان کنیم که «صحیح» حتی به چه معناست. صحت توسط مشخصات (spec) تعریف میشود. در برخی برنامهها، راه واضحی برای تعیین رسمی رفتار مورد نظر برنامه وجود دارد. برای مثال، یک رمزگشا PNG یک رشته بایت را دریافت کرده و (پیروی از RFC 2083) این بایتها را به تصویر متناظر رمزگشایی میکند. اما برای اکثر برنامهها، اوضاع اینقدر ساده نیست. «صحیح» بودن یک ویرایشگر متن یا مرورگر وب به چه معناست؟ دشواری دستیابی به یک مشخصات جامع و بدون ابهام، مانع قابل توجهی برای صحتسنجی نرمافزار در مقیاس بزرگتر است.
برای پرداختن به این مسئله برای کد موجود در کتابخانههای متنبازی که قصد اثبات آنها را داشتیم، ما رویکرد تبدیل خودکار مجموعه تستهای قابل کامپایل موجود آنها به یک مشخصات را اتخاذ میکنیم، با کدگذاری قاعده «این مجموعه تست همیشه پاس میشود»، با استفاده از یک مدل عمومی از آنچه به معنای اجرای هر باینری کامپایلشده RISC-V روی لینوکس است. به طور تاریخی، اثبات چنین مشخصاتی غیرقابل حل بود، با توجه به پیچیدگی ذاتی نوشتن اثباتی که بتواند تمام رفتارها و تعاملات ممکن دهها هزار دستور اسمبلر را برای هر ورودی در بر بگیرد و استدلال کند (و این واقعیت که اثباتها در نتیجه معمولاً بسیار بزرگ هستند). اینجا جایی است که LLMهای امروزی وارد میشوند: گذر از میلیونها خط کد در پی یک هدف تعریفشده خوب، وظیفهای است که LLMها برای آن بسیار مناسب هستند.
برای این پروژه، ما با تستهای فازی (Fuzz tests) شروع کردیم. در این تستها، توسعهدهندگان یک نقطه ورود2 در کد خود مینویسند که ورودیهایی را دریافت میکند، به طوری که هر ورودی که باعث کرش شود، باگی است که نویسندگان نسبت به آن اهمیت دارند. سپس فازر (Fuzzer)، یک موتور آزمایش، تعداد عظیمی از ورودیهای نیمهتصادفی و جهشیافته را در نقطه ورود تولید میکند تا سعی کند باگی را پیدا کند (تصویرسازی شده در شکل ۱). هرچه فازر مدت بیشتری اجرا شود، باگهای بیشتری پیدا میکند. اما این ذاتاً یک فرآیند خشونتآمیز (Brute-force) است، بدون تضمین تمرین هر مسیر کد ممکن، صرفنظر از تعداد ورودیهایی که امتحان میکنید.
برای یافتن همه باگهایی که توسط یک تست فازی آشکار میشدند، ما تست فازی را به یک مشخصات تعریفشده روی دستورات اسمبلر کامپایلشده RISC-V تبدیل کردیم. مشخصات میگوید که تست فازی برای هر ورودی کمتر از ۶۴ مگابایت کرش نخواهد کرد.3 اگر کلود بتواند این مشخصات را اثبات کند، تست فازی روی RISC-V زائد میشود: فازینگ آن نقطه ورود هرگز هیچ باگی پیدا نخواهد کرد.
ما این کار را برای صدها پروژه در ابتکار OSS-Fuzz گوگل انجام دادیم، که تست فازی مداوم را برای پروژههای متنباز واجد شرایط فراهم میکند. OSS-Fuzz شامل هزاران نقطه ورود نوشتهشده توسط توسعهدهندگان است که به دنبال خواص شکسته کد با ایجاد کرش (مثلاً هنگام شکست یک ادعا) میگردند. OSS-Fuzz به طور خودکار برنامههای C و ++C را با AddressSanitizer4 (ASan) ابزارگذاری میکند، که باعث میشود هرگاه حافظه به طور نامناسب دسترسی یابد، کرش کنند (که علت اصلی آسیبپذیریهای نرمافزاری است). مشخصات طیف گسترده مانند ایمنی حافظه تقریباً به تمام نرمافزارها اعمال میشود.
در طول چند هفته، کلود موفق شد باگهایی را که پیدا کرد وصله کند و سپس اثبات کرد که هیچ کرشی روی هیچ ورودی (تا ۶۴ مگابایت) برای ۲۳۹ نقطه ورود در سراسر ۱۲۳ کتابخانه مختلف OSS-Fuzz وجود ندارد. این اثباتها روی دستورات اسمبلر کامپایلشده RISC-V (یعنی باینریهای اجرایی) عمل میکنند و شامل حدود ۱۸۰ میلیون خط Rocq هستند، با یک اثبات نمونه که حدود ۶۰۰,۰۰۰ خط طول میکشد تا تضمینهای امنیتی را برای باینریهایی با طول میانه ۱۸,۰۰۰ دستور اسمبلر RISC-V فراهم کند. این اثباتها با ترجمه کد اسمبلر RISC-V به یک مدل ریاضی با استفاده از معانی دستور RISC-V و فرآیند لینوکس تئورم ساخته میشوند. این بدان معناست که این اثباتها در حال حاضر فرض میکنند که برنامه به عنوان یک باینری استاتیک تکرشتهای با بودجه حافظه ثابت روی پردازنده RISC-V با سیستمعامل لینوکس اجرا میشود. گسترش دامنه این اثباتها کاملاً در دسترس است، زیرا مستلزم استانداردسازی معانی برای معماریهای اسمبلر بیشتر و سایر فرآیندهای سیستمعامل است. دیدگاه یک متخصص درباره اثباتهایی که کلود نوشت را ببینید.
در حالی که این حجم عظیمی از کد اثبات است، عملاً هیچکدام از آن نیاز به بازبینی دستی ندارد. بررسیکننده اثبات Rocq اطمینان حاصل میکند که مشخصات به درستی توسط اثبات برآورده میشود. در نتیجه، تنها مصنوعاتی که یک توسعهدهنده باید به آنها اعتماد کند عبارتند از:
- مدلهای رسمی RISC-V و فرآیندهای لینوکس؛
- بیانات دقیق قضایایی که اثبات شدند؛
- خود بررسیکننده اثبات Rocq.5
این به معنای آن نیست که این کتابخانهها هیچ باگی ندارند. بلکه به این معناست که هر باگ باقیمانده یا باید در مصنوعات ذکرشده در بالا یافت شود یا خارج از دامنه اثبات کلود است. سختگیری آن اجزای مورد اعتماد که همچنان ممکن است دارای باگ باشند (Rocq، معانی RISC-V و لینوکس) ناچیز نیست، اما وظیفهای بسیار قابل مدیریتتر نسبت به اشکالزدایی هر خط کدی است که اثباتهای مقیاسیافته پوشش میدهند—به ویژه چون این رویکرد میتواند تعداد دلخواهی پروژه را ایمن کند بدون افزایش اندازه اجزای مورد اعتماد.
ما از بازبینی مستقل اثباتهای خود استقبال کرده و اصلاح رویکرد ما را تشویق میکنیم. به این منظور، ما اجزای مورد اعتماد (بالا) ساختهشده برای این پروژه که قبلاً عمومی نشدهاند را منتشر میکنیم؛ اثباتهای کامل Rocq کلود برای تستهای فازی که نیازی به وصله نداشتند؛ و مشخصات برای سایر تستهای فازی که نتوانستیم اثبات کنیم.
یافتن و اصلاح باگها
در بالا، نشان دادیم که چگونه میتوان تستهای نوشتهشده توسط توسعهدهندگان (تستهای فازی) بسیاری از کتابخانههای متنباز را به مشخصاتی تبدیل کرد که کلود میتواند اثبات کند همیشه پاس میشوند، گاهی پس از وصله کردن باگهای باقیماندهای که پیدا کرده است. به همین دلیل، فرآیند تلاش برای اثبات این مشخصات، صدها باگ را کشف کرد.
بسیاری از باگها در طول تلاشهای کلود برای اثبات صدها نقطه ورود ظاهر شدند. برای اطمینان از اینکه کلود مجبور نبود هر بار که این اتفاق میافتاد برای انسان متوقف شود، اجازه دادیم کلود باگهایی را که پیدا میکند اصلاح کند: کد را وصله کرد، که باعث شد مشخصات با آن کد وصلهشده دوباره تولید شود، و سپس کلود به اثبات آن مشخصات جدید ادامه داد.6
بسیاری از باگهایی که یافتیم، باگهایی هستند که بعید است یک فازر هرگز آنها را پیدا کند. فازرها ورودیهای کوچک را جهش میدهند، معمولاً با سقف ۱ مگابایت، و معمولاً برای هدایت به سمت باگها به پوشش کد تکیه میکنند. هنگام اثبات یک نقطه ورود در یک کتابخانه، کلود یک سرریز منفی شمارنده (Underflow) در نسخه خودش از یک رمزگشا یافت که منجر به نوشتن خارج از محدوده شد، اما فقط روی ورودیهای حدود ۲۰ مگابایتی که یک چیدمان خاص و نادر داشتند. سایر باگها شامل خواندن خارج از محدوده در یک رمزگشای تصویر بود که به ورودی ۶۴ مگابایتی و بیش از ۲ گیگابایت حافظه نیاز داشت، خواندن خارج از محدوده در کتابخانه دیگر که به توالی خاصی از فراخوانیها در دو هندل به همان فایل نیاز داشت، و کشف مجدد CVE-2026-56132 در libexpat، که به ورودی عمیقاً تودرتو نیاز داشت. کلود همچنین باگهای منطقی را یافت که اصلاً کرش نمیکنند. برای مثال، هنگام اثبات اینکه یک کتابخانه از نظر حافظه ایمن است، متوجه شد که یک ویژگی برای محدود کردن فایلهایی که یک برنامه میتواند بارگذاری کند، همیشه اعمال نمیشود.
هدف نهایی این پروژه دستیابی به اثباتی بود که نشان دهد تستهای فازی کامپایلشده RISC-V هیچ کرش باقیماندهای برای یافتن ندارند. با این حال، باگهایی مانند موارد فوق نشان میدهند که این فرآیند فایده دیگری نیز دارد، صرفنظر از اینکه آیا آن هدف محقق شود یا خیر: حتی صرفاً تلاش برای این فرآیند، باگهای واقعی را که نیاز به اصلاح دارند، به ارمغان میآورد.
اثبات فراتر از ایمنی حافظه
اثبات اینکه یک تست فازی دیگر کرشی برای یافتن ندارد، مهمتر از آن چیزی است که به نظر میرسد. رایج است که تستهای فازی در کد دنیای واقعی، نقض خواص معنادار سطح بالا را آزمایش میکنند، مانند رفت و برگشت کدگذاری-رمزگشایی، خودتوانی (Idempotence)، قوانین جبری، آزمایش تفاضلی، خودثباتی، یا همارزی با پیادهسازیهای مرجع. برای مثال، یک تست فازی برای الگوریتم فشردهسازی LZO ادعا میکند که اگر ورودی را فشرده کنید و سپس آن را رمزگشایی کنید، نتیجه همان اصل است. اگر خاصیت برقرار نباشد، برنامه کرش میکند—بنابراین اثبات اینکه تست هرگز کرش نمیکند معادل اثبات خودِ خاصیت است.
این حتی زمانی نیز رخ میدهد که خواص مستقیماً توسط توسعهدهنده مشخص نشده باشند. برای مثال، برای اینکه کلود اثبات OSS-Fuzz خود را برای cpp-httplib تکمیل کند، لازم بود امکان سرریز پشته (Stack overflow) ناشی از بازگشت زیاد در تجزیهکننده std::set را رد کند. عمق این بازگشت توسط حداکثر عمق یک درخت محدود میشود، بنابراین کلود مجبور بود (روی کد ماشین!) اثبات کند که الگوریتم تعادلبخشی درخت قرمز-سیاه libc++ به درستی بهینه شده است تا عمق درخت را به صورت لگاریتمی محدود نگه دارد.
سایر مطالعات موردی صحتسنجی رسمی
صحتسنجی رسمی دامنهای گسترده است. مثال تبدیل تست فازی به اثبات در بالا یکی از مواردی است که LLMها با اعمال مستقیم اثباتها بر کد ماشین، صحتسنجی رسمی را برای استفاده گستردهتر امکانپذیر میکنند.
ما همچنین موفقیتهایی را در استفاده از LLMها با صحتسنجی رسمی به روشهای دیگر دیدهایم. برای مثال، از کلود خواستیم یک مشخصات رسمی از RFC 1950، سند فنی که قالب فایل فشردهسازی zlib را تعریف میکند، بنویسد. سپس، کلود را واداشتیم اثبات کند که پیادهسازی zlib در هسته لینوکس به درستی آن مشخصات را پیادهسازی میکند. همانند مثالهای بالا، کلود این خاصیت را در سطح باینری اثبات کرد، اما به جای RISC-V، کلود مستقیماً باینری کامپایلشده x86 را با استفاده از معانی رسمی ISA x86 تولیدشده توسط کلود (و به شدت آزمایششده) اثبات کرد.7 سپس این فرآیند را برای نیم دوجین کتابخانه پرکاربرد دیگر تکرار کردیم. در این مسیر، برخی باگهای جزئی (غیرقابل سوءاستفاده) در موارد لبه (Corner cases) یافتیم که در حال ثبت در بالادست هستند. ما دو نتیجه از این تمرین میگیریم: (۱) این پایگاههای کد به شدت آزمایششده تقریباً کاملاً صحیح هستند، و (۲) امکان اثبات خواص صحت پایانبهپایان درباره پایگاههای کد واقعی موجود وجود دارد.
در یک آزمایش دیگر، از کلود خواستیم یک مفسر برای زیرمجموعهای بزرگ از پایتون در زبان Rust توسعه دهد و (با استفاده از Verus، یک ابزار صحتسنجی برای Rust) اثبات کند که به معانی CPython ترسیمشده در یک مقاله دانشگاهی پایبند است. سپس پایبندی به رفتار CPython را به طور تجربی اندازه گرفتیم، با اجرای بیش از ۱.۷ میلیون برنامه پایتون تصادفی تولیدشده، و یافتن رفتار یکسان با CPython در ۹۹.۹۵٪ از آزمایشها، با تفاوتهای آزمایشی باقیمانده به عنوان موارد لبه شناختهشده غیرتعجبآور.
ما همچنین مشکلاتی را در چندین برنامه پرکاربرد و حیاتی از طریق تلاشهای صحتسنجی رسمی برای خواص امنیتی ساده یافتیم. در یکی از آنها، یک باگ منطقی ناشناخته قبلی را کشف کردیم که بیش از یک دهه نهفته بود. در طی تلاشی برای صحتسنجی یک خواننده PDF پرکاربرد، در یک هفته به تعدادی باگ امنیتی رسیدیم که معمولاً در یک سال گزارش میشوند.
برای جزئیات بیشتر درباره برخی از این تلاشها، به پیوست مراجعه کنید.
این تنها آغاز است
یکی از محدودیتهای کلیدی صحتسنجی رسمی کمکی LLM این است که اثباتها میتوانند صدها میلیون توکن برای تولید نیاز داشته باشند. کارایی هزینه حیاتی است اگر هدف ما در دسترس قرار دادن این روشها برای کل اکوسیستم نرمافزار باشد. خوشبختانه، دلایل متقاعدکنندهای برای انتظار بهبود کارایی وجود دارد.
مدلهای جدیدتر به توکنهای کمتری نیاز دارند
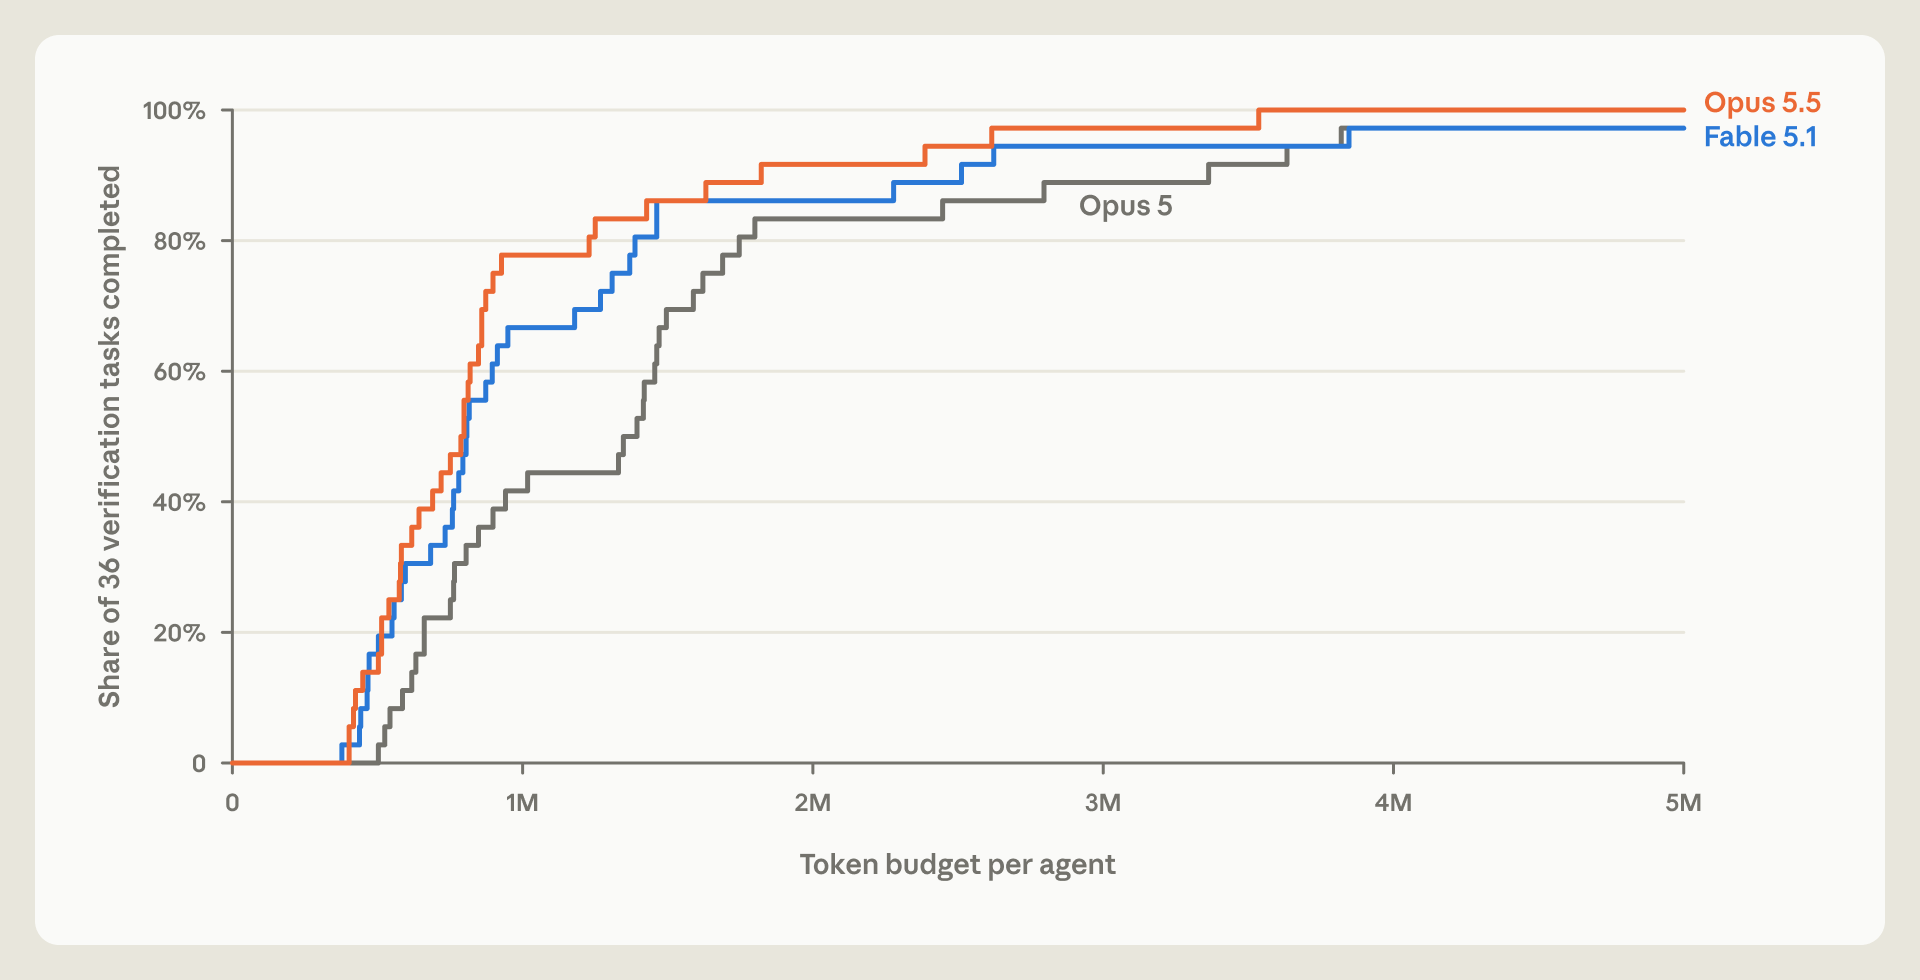
ما ۳۶ وظیفه صحتسنجی کوچک از کد واقعی OSS-Fuzz ساختیم. Opus 5.5 نیمی از آنها را با حدود ۴۰٪ توکن کمتر از Opus 5 اثبات میکند. انتظار داریم این روند با آموزش مدلها بر وظایف صحتسنجی طولانی ادامه یابد.
اثباتها قابل استفاده مجدد هستند
وقتی عوامل به صورت جداگانه کار میکنند، اغلب در نهایت بخش زیادی از تلاش را تکرار میکنند. اثباتها، مانند نرمافزار، به صورت بازگشتی از اثباتهای کوچکتر ساخته میشوند—و هرچه اثباتها کوچکتر باشند، معمولاً قابل استفاده مجددتر هستند. برای اندازهگیری تأثیر این موضوع، اجازه دادیم عوامل هنگام کار روی اثبات اهداف خود، اثباتهای یکدیگر را کپی کنند. وقتی به این فضای کاری مشترک دسترسی داده شد، عوامل به ۱۷٪ توکن کمتر از زمانی که تنها کار میکردند نیاز داشتند، و برخی عوامل حتی پس از شکست در تلاش انفرادی قبلی موفق شدند.
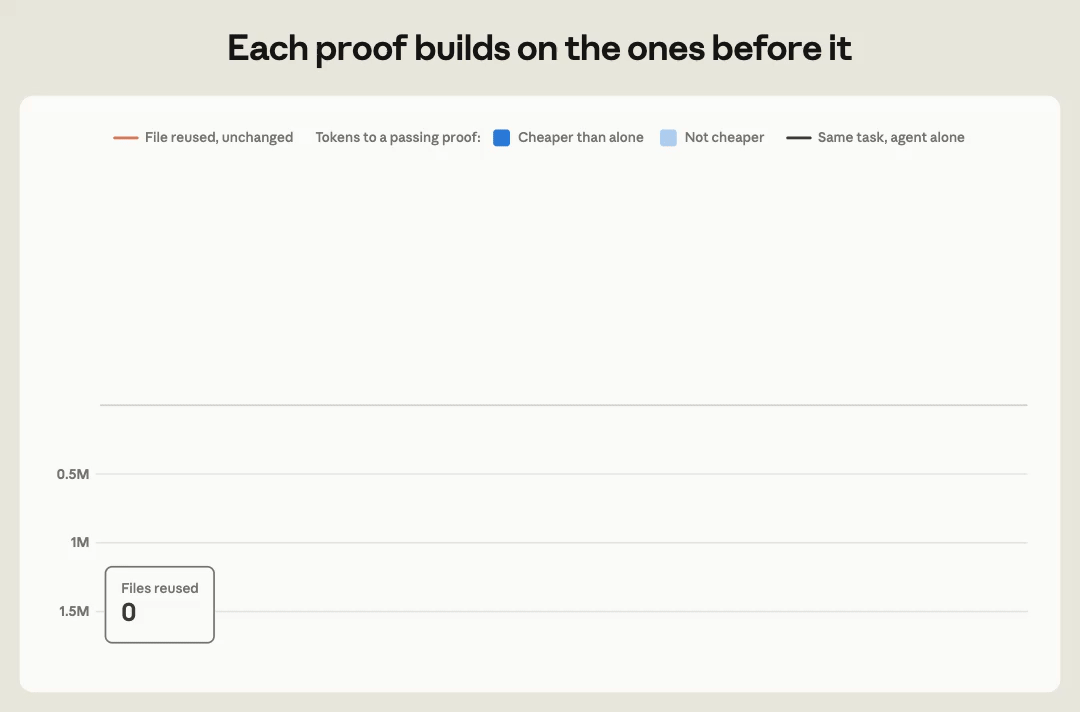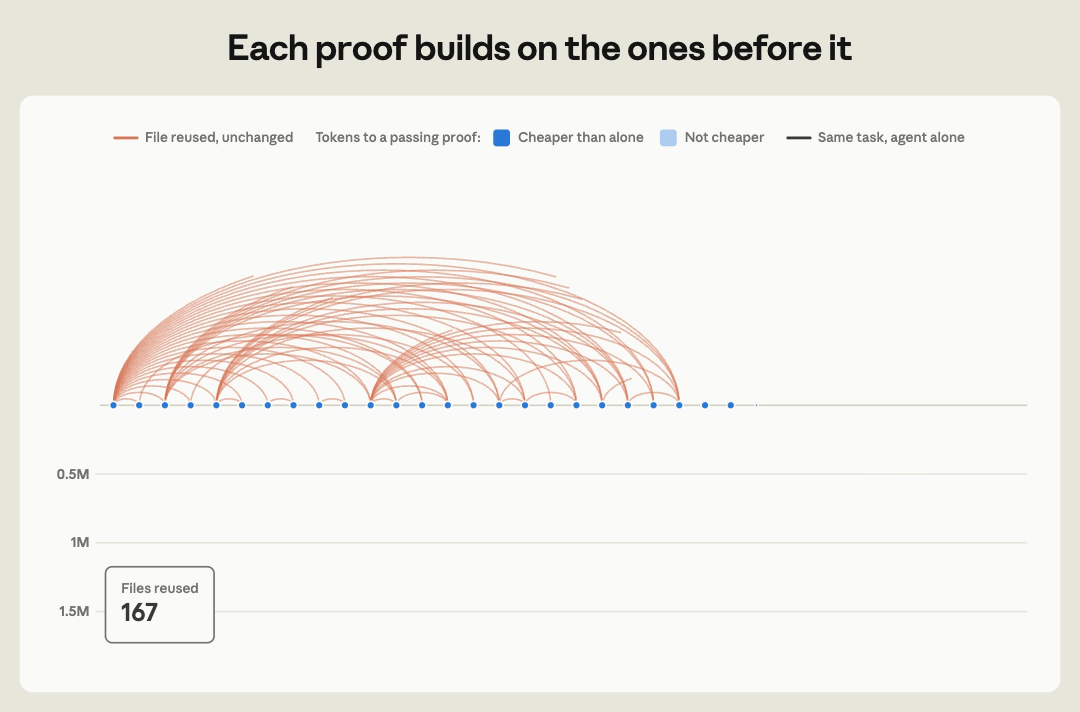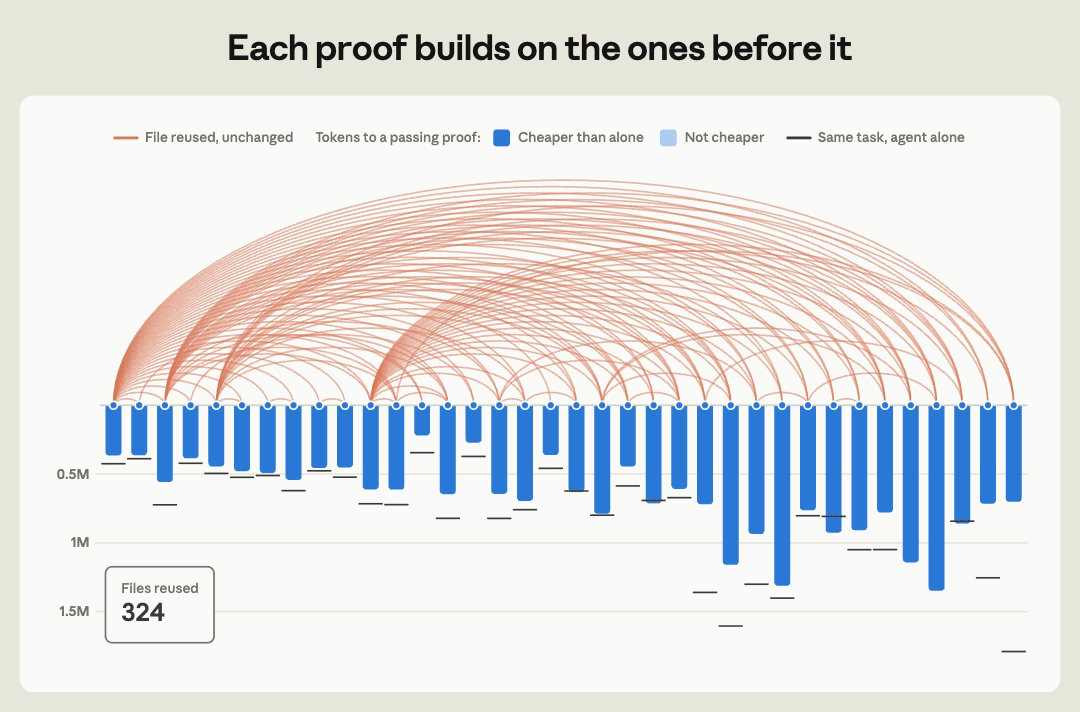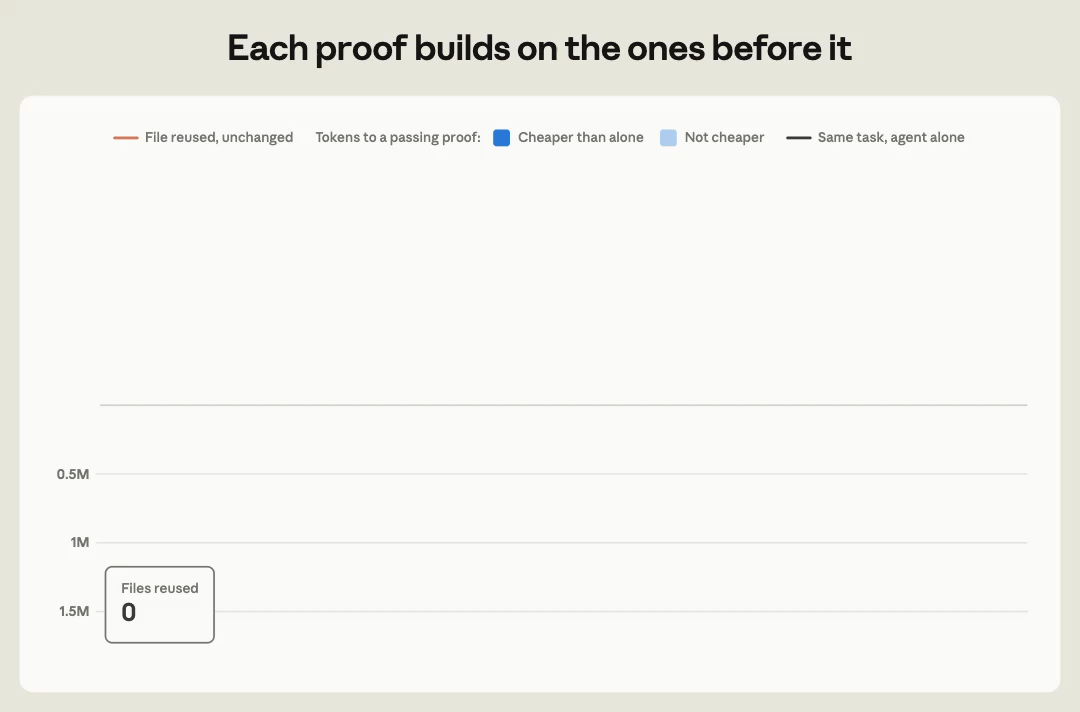
ما همان پدیده را در مقیاس بزرگ در طول تلاش اثبات OSS-Fuzz خود مشاهده کردیم. بخش عمدهای از یک اثبات مربوط به کدی است که هر برنامهای شامل آن است (به ویژه مقداردهی اولیه زمان اجرا C و AddressSanitizer)، بنابراین برنامههای بسیار متفاوت میتوانند در نهایت اثباتهای همپوشانی قابل توجهی داشته باشند. تیمهای عامل از این موضوع بهره بردند با کپی کردن اثبات تکمیلشده تیم دیگر و سپس تطبیق آن با برنامه خود (شکل ۶).
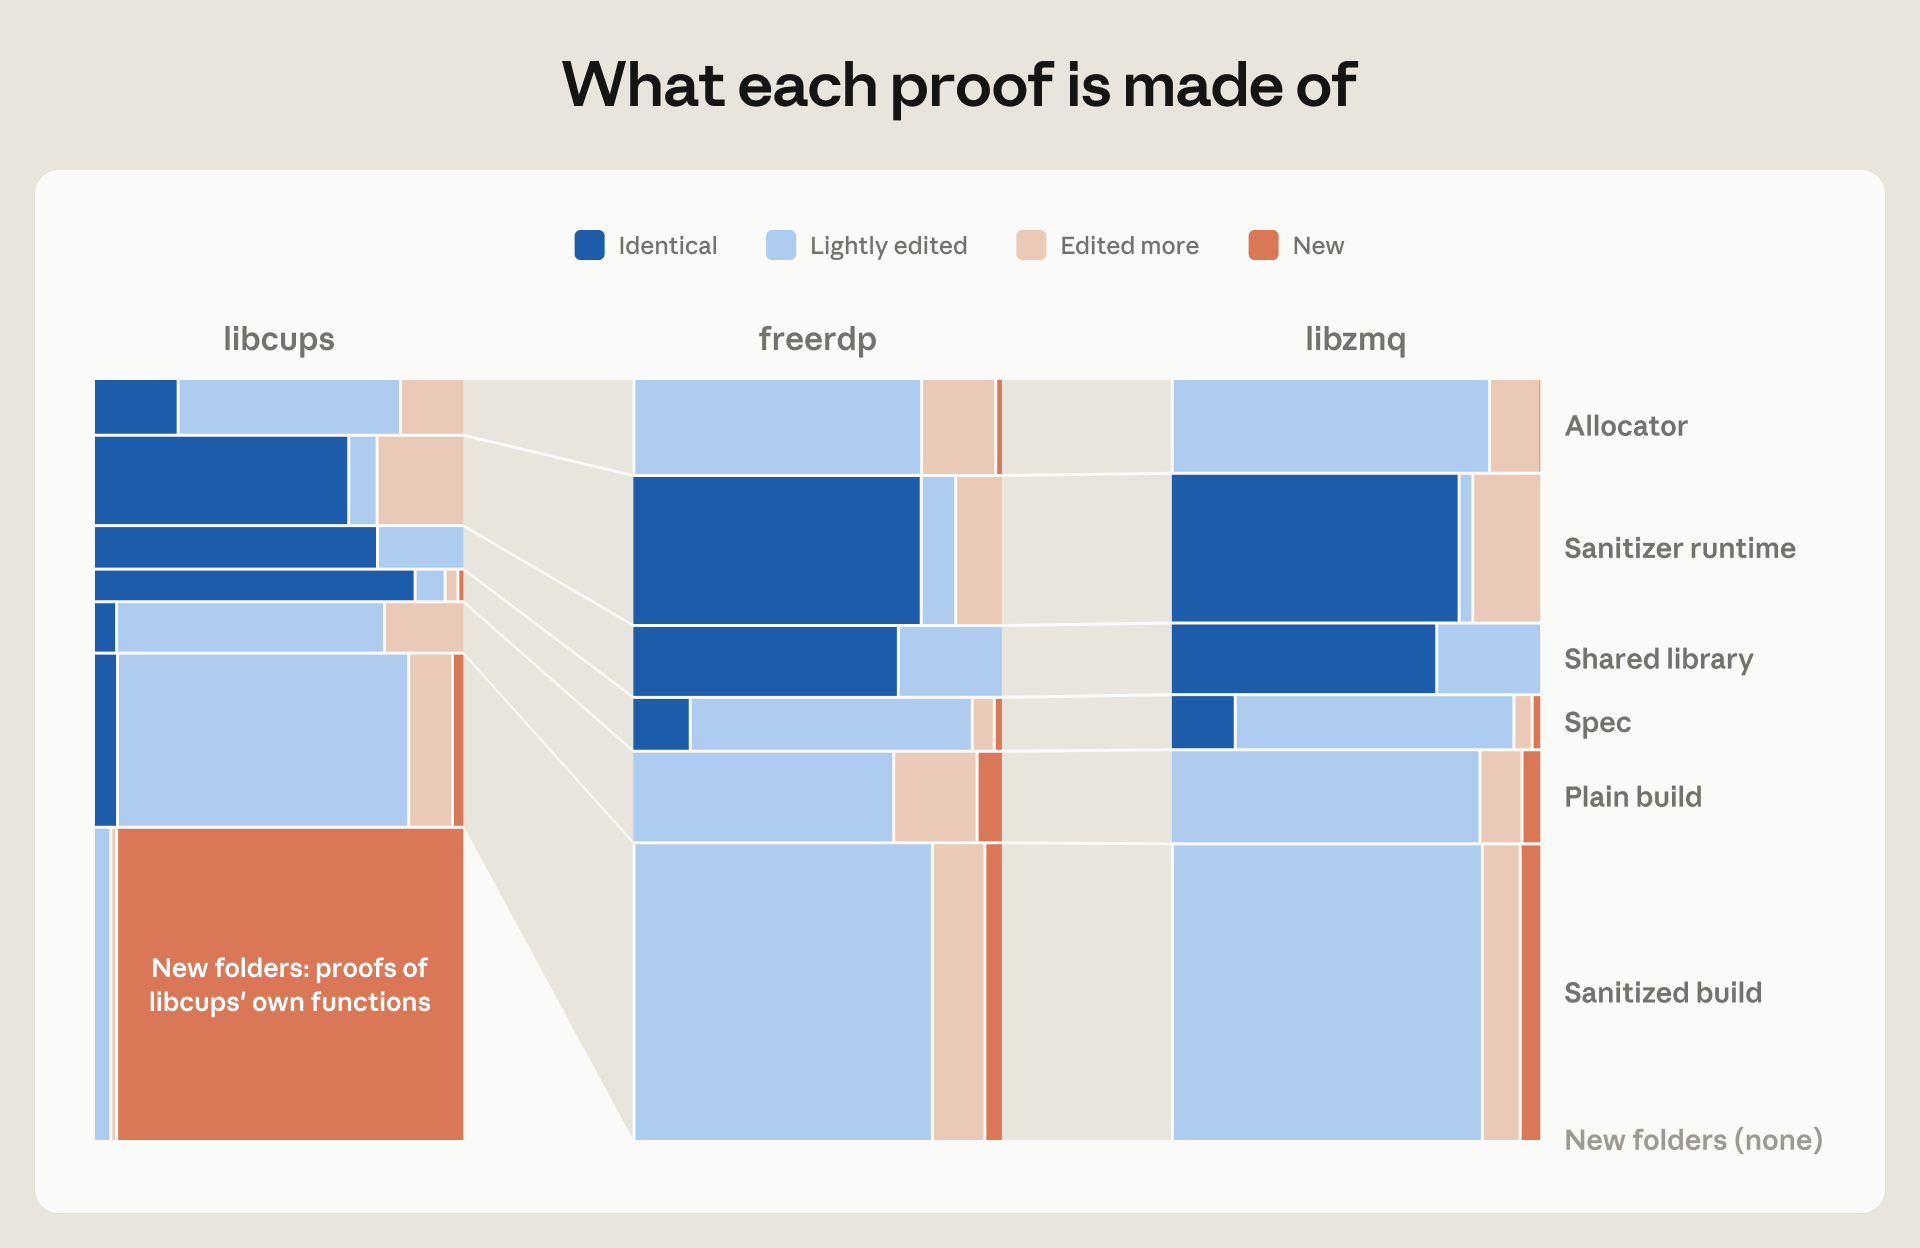
این قابلیت استفاده مجدد اثباتها نحوه رشد Mathlib، یک کتابخانه مشترک ریاضیات رسمی در Lean، به نزدیک ۳۰۰,۰۰۰ قضیه ارسالشده توسط بیش از ۷۰۰ مشارکتکننده است: هر اثبات جدید بر بدنه کار موجود بنا میشود. ما بدنه مشابهی از اثباتها را در طول تلاش OSS-Fuzz خود انباشته کردیم، برخی از آنها را در انتشار خود شامل میکنیم (ما اثباتهایی که ممکن است باگ وصلهنشدهای را در نرمافزار متنباز آشکار کنند منتشر نمیکنیم).
با فارغالتحصیل شدن از این آزمایشهای اولیه، ما به استراتژیای برای صحتسنجی بدنه عظیم نرمافزار موجود نیاز داریم، با شروع از وابستگیهای حیاتیترین. همانطور که نشان دادیم، این میتواند در مقیاس بزرگ با استفاده از مشخصات عمومی و کار در سطح باینری محقق شود، با دور زدن نیاز به بازنویسی کل پایگاههای کد به زبان دیگر.
این رویکرد همچنین استفاده مجدد از اثباتها را در دانهبندی سطح بسته تسهیل میکند، که به معنای آن است که هر وابستگی فقط یک بار نیاز به صحتسنجی دارد. وابستگیها از قانون توان پیروی میکنند: اثبات حتی مجموعه کوچکی از کتابخانههای مشترک، بخش عظیمی از نرمافزار را قابل اثبات میکند. برای جزئیات بیشتر، به نقشه راه تئورم برای صحتسنجی کل اکوسیستم Nix مراجعه کنید، که شامل زیرساختهای حیاتی مانند glibc، OpenSSL و cURL است.
محدودیتها
در عمل، صحتسنجی رسمی گاهی اوقات کمتر از آنچه میخواهیم درباره امنیت کد اثبات میکند.
«صحتسنجی رسمی شده» به معنای «بدون باگ» نیست. کلود میتواند اثباتی بنویسد که نشان دهد رفتار یک برنامه کامپایلشده الزامات یک مشخصات رسمی (که توسط یک بررسیکننده اثبات خارجی صحتسنجی میشود) را برآورده میکند. با این حال، یک بررسیکننده اثبات نمیتواند به شما بگوید آیا مشخصات شما با واقعیت مطابقت دارد یا خیر. برای مطابقت با واقعیت، مشخصات باید همه چیز درباره ماشین دنیای واقعی که برنامه صحتسنجیشده روی آن اجرا میشود، از جمله CPU و سیستمعامل را به درستی در بر بگیرد و مدلسازی کند. وقتی باگها در کد صحتسنجیشده ظاهر میشوند، به این دلیل است که مشخصات، یا معانی فرضی ماشین، با واقعیت متفاوت است. خوشبختانه، این همچنین به معنای آن است که ما میدانیم کجا را برای باگهای باقیمانده جستجو کنیم و چگونه سیستمی طراحی کنیم که آن شکافهای همچنان ممکن دارای باگ به حداقل برسند. در زیر روشهایی آورده شده که این در اثباتهای ما اعمال میشود، و ایدههایی برای کار آینده که آن شکافها را پر خواهند کرد.
ماشین واقعی کاری انجام میدهد که مدل توصیف نمیکند. اثباتهای ما درباره باینریهای استاتیک تکرشتهای RISC-V لینکشده علیه musl libc هستند. با این حال، اکثر افراد این کتابخانهها را روی x86 یا ARM اجرا کرده و به صورت پویا علیه glibc لینک میکنند. برای پر کردن این شکاف، به مدلهای سیستمی نیاز داریم که بیشتر شبیه سیستمهای استقراریافته باشند. برای مثال، یک قدم به سوی این موضوع تولید معانی دقیق برای x86 است.
ادعا ممکن است همه آنچه مراقب آن هستیم را پوشش ندهد. ما اثبات کردیم که کرش هرگز برای هیچ ورودی زیر ۶۴ مگابایت در بسیاری از نقاط ورود فازینگ در Google OSS-Fuzz، شامل کرشهای ASan، تحریک نمیشود. با این حال، ASan همه باگهای ایمنی حافظه را تشخیص نمیدهد و ما همه نقاط ورود را برای هر کتابخانه صحتسنجی نکردیم. حتی اگر کرده بودیم، کل کتابخانه با صحتسنجی همه نقاط ورود پوشش داده نمیشد (به ویژه اگر کد مرده وجود داشته باشد). علاوه بر این، برنامههای واقعی ممکن است از کتابخانه سوءاستفاده کنند، که منجر به فساد حافظه در فراخواننده میشود. برای پر کردن آن شکاف، باید مشخص کنیم فراخوانندگان برای هر تابع عمومی چه کاری باید انجام دهند، و فراخوانندگان باید به سختی به آن پایبند باشند.
انتظار داریم با یادگیری بیشتر درباره بهرهبرداری از LLMها برای روشهای رسمی، و با ادامه بهبود مدلها، این محدودیتها قابل مدیریت شوند و بتوانیم درصد بسیار بزرگتری از کدی که به آن تکیه میکنیم را صحتسنجی کنیم.
نتیجهگیری
مسیر روشن است: صحتسنجی رسمی، که به طور تاریخی فقط برای تضمینهای دستساز متخصصان در کدهای ایمنیمحورترین عملی بود، به زودی برای تقریباً تمام نرمافزارهای تولیدی به همان اندازه که فازینگ امروز عملی است، عملی خواهد شد. درست مانند انواع ایستا، چارچوبهای آزمایش و سایر ابزارهای صحت، صحتسنجی از «اضافهشده» به «ساختهشده درونی» بالغ خواهد شد، نه تنها توسط LLMها بلکه توسط نوآوریها در طراحی زبان و جریانهای کاری توسعه هدایت میشود.
در دنیای امروز—که LLMها به طور خودکار آسیبپذیریهای کد را اسکن کرده و بیشتر پیدا میکنند—ما باید از فرآیندهایی استفاده کنیم که بتوانند خواص امنیتی کد را تضمین کنند. صحتسنجی رسمی مقیاسیافته LLM رویکردی امیدوارکننده به سوی ایمنسازی این تضمینها در دامنه و مقیاسی است که قبلاً دستنیافتنی بود. ما دیگران را تشویق میکنیم آزمایش کنند تا بتوانیم جماعی جهانی بسازیم که در آن نرمافزارهای مقاوم به طور گسترده تکثیر شده و باگهای نرمافزاری کمیابی شناختهشده و سریع قابل رفع باشند.
پیوست کامل را بخوانید.