در شرکت Anthropic، کدنویسی دیگر گلوگاه ساخت سیستمها یا انجام تحقیقات نیست. Claude قادر است حلقههای تحقیقاتی را به صورت خودکار تکرار کند، برنامههای پیچیده را ریزبهریز بهینه کند و خدمات جدید را از پایه با سرعت و مقیاسی بسازد که پیش از این بیسابقه بوده است. اکنون، گلوگاه اصلی تمام زیرساختهای توسعهای است که برای مقیاس انسانی ساخته شدهاند: کنترل منبع، بیلدها (Builds) و CI.
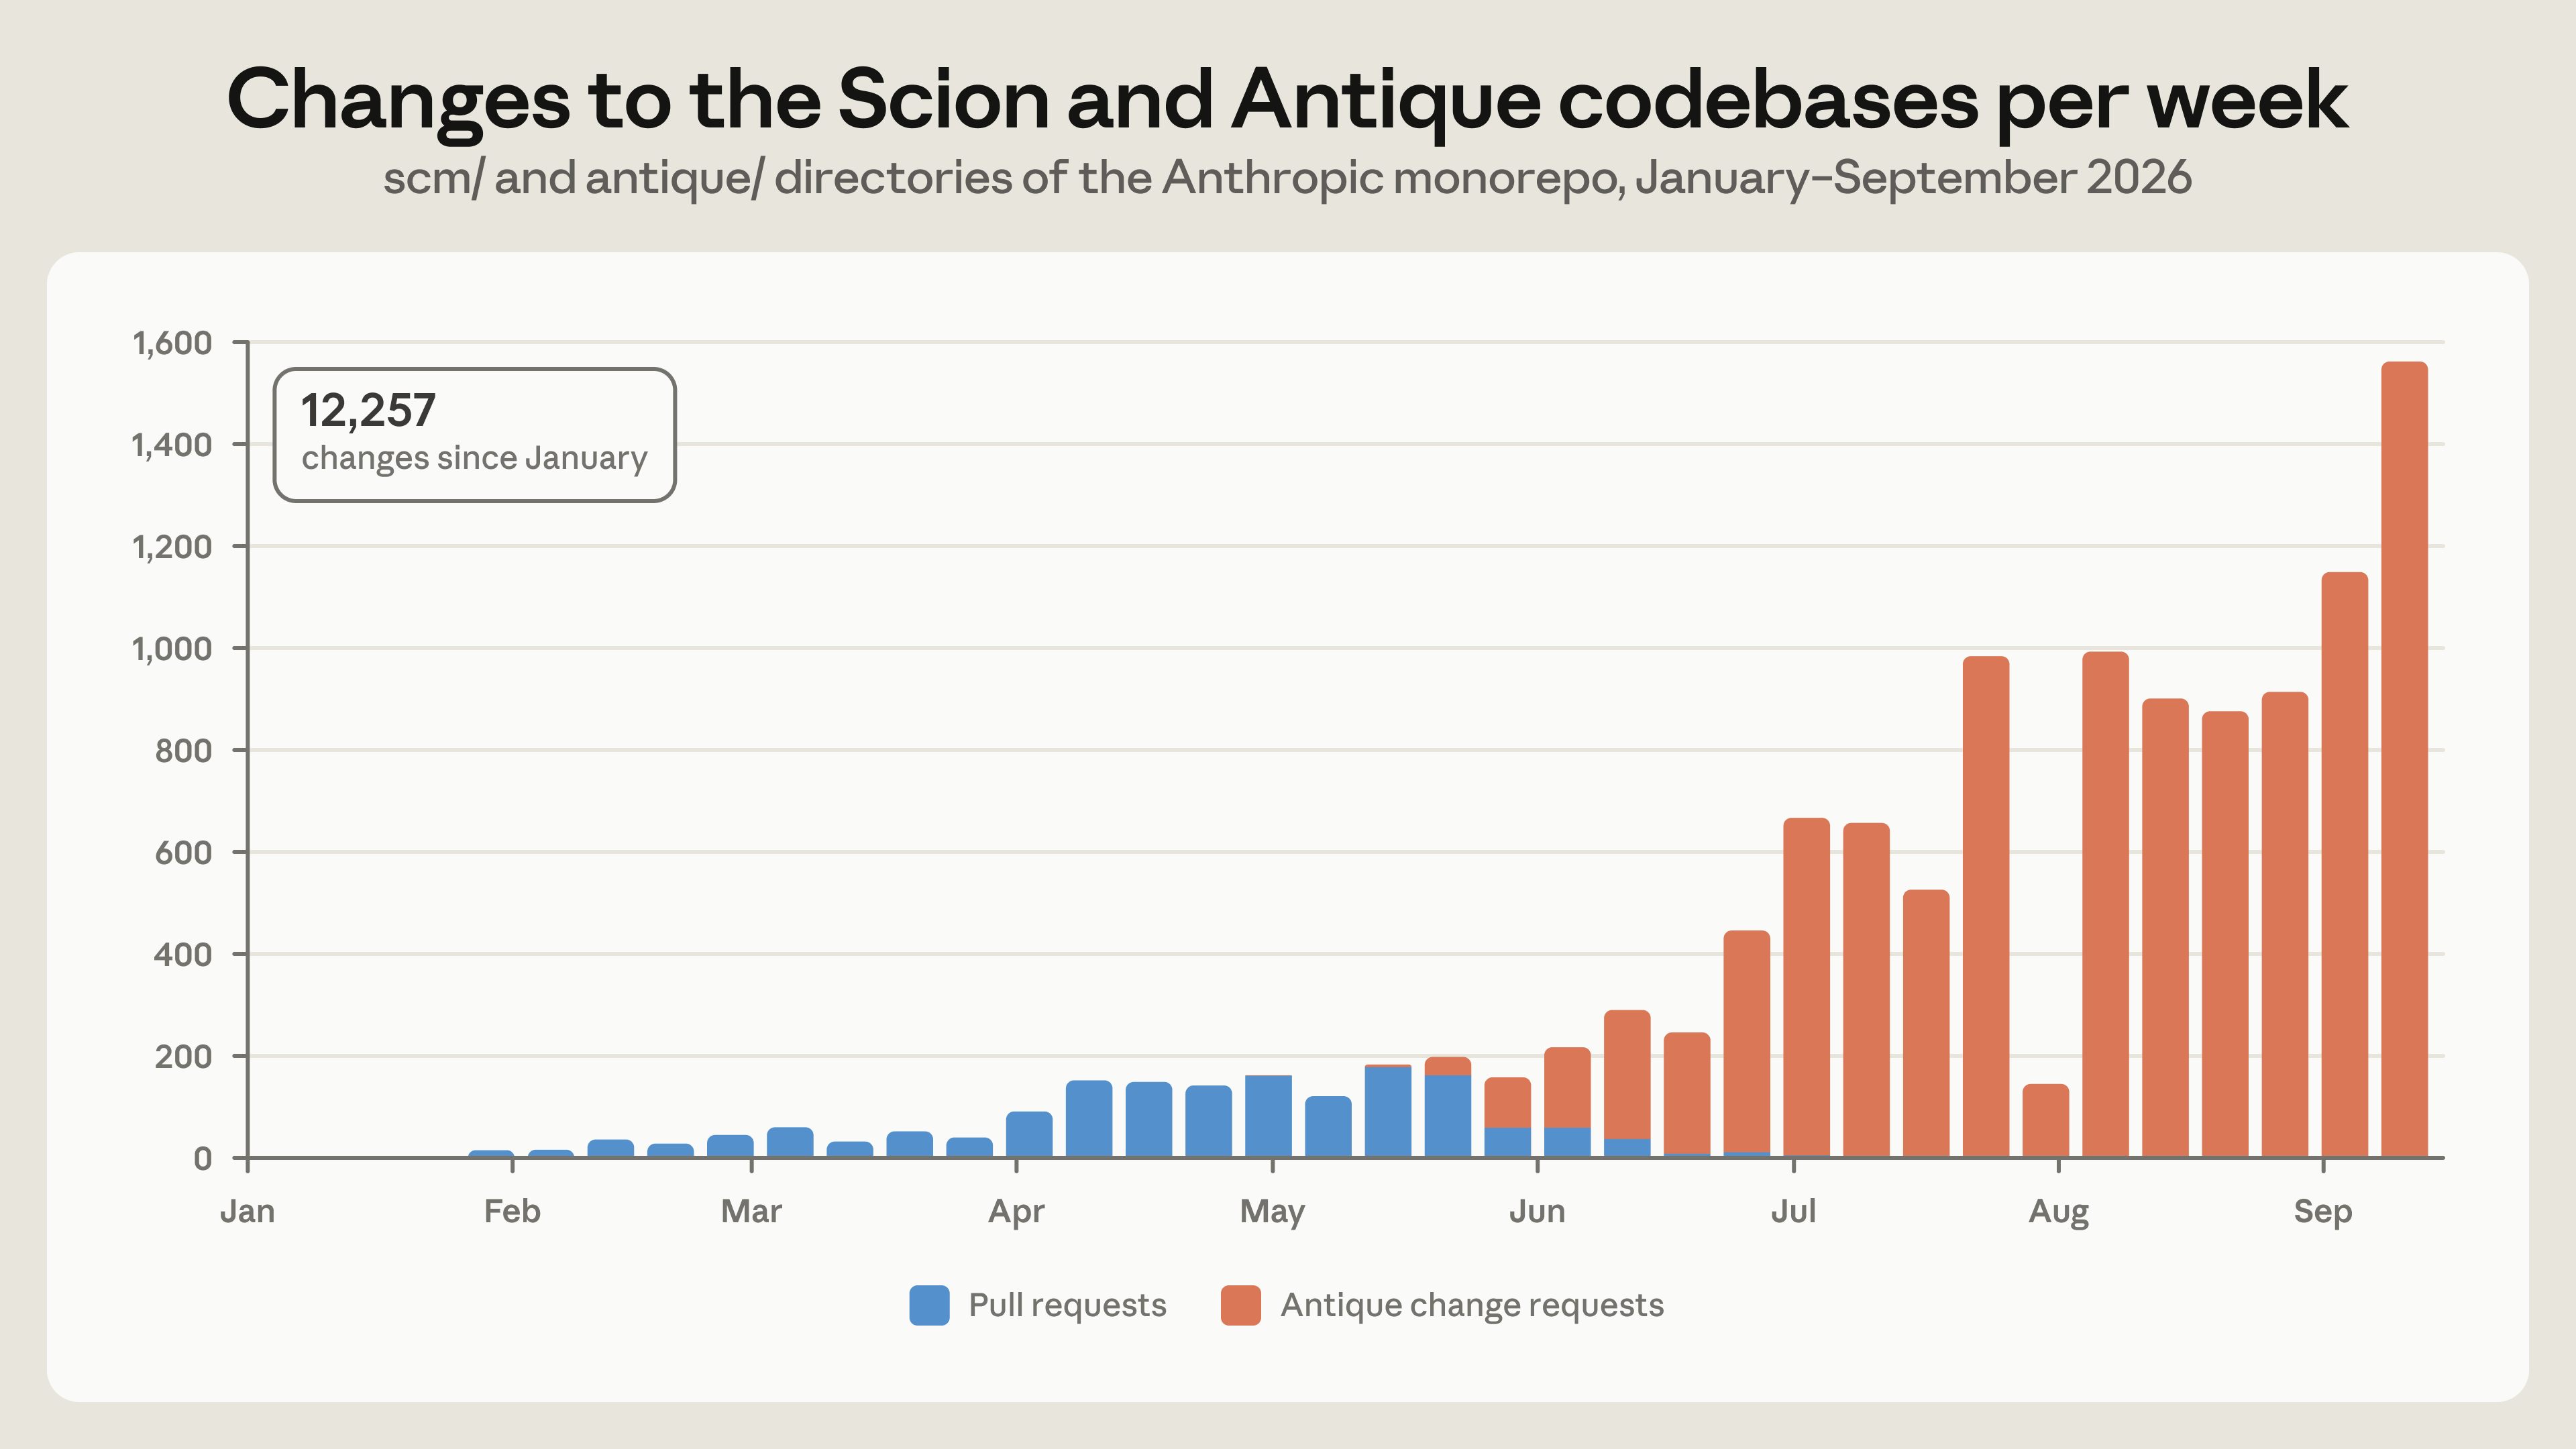
در مه ۲۰۲۶، Anthropic به طور میانگین حدود ۲,۵۰۰ تغییر کد را در روز ادغام میکرد؛ از سپتامبر، ما بیش از ۳۰,۰۰۰ مورد را در روز ادغام میکنیم. انتظار نداریم این نرخ رشد به زودی کاهش یابد؛ تقاضای نهفته برای ادغام کد عملاً نامحدود است و هر گلوگاهی که حذف کنیم، بلافاصله منجر به افزایش بیشتر حجم کد تولیدی میشود.
برای پشتیبانی از این رشد، ما Scion را به عنوان یک سیستم کنترل نسخه داخلی ساختیم و مونوریپوی خود را در پنج ماه به طور کامل از Git مهاجرت دادیم. همچنین در همان بازه زمانی، یک سطح بازبینی کد (به نام Antique)، جستجوی کد، یک سیستم IAM غنی برای کنترل منبع، روشهای نوآورانه برای مدیریت و ادغام حجم عظیمی از کدهای بازبینیشده و موارد دیگر را ساختیم و راهاندازی کردیم. در این پست، تمرکز ما بر نحوه ساخت Scion خواهد بود. این موضوع مطالعه موردی جالبی است: توانایی Claude در نوشتن کد هم چیزی بود که ما را در ابتدا به این وضعیت رساند و هم ابزاری که به ما امکان داد به سرعت یک سیستم باکیفیت و مقیاسپذیر برای مقابله با آن بسازیم.
رشد مونوریپوی ما
قبل از بررسی آنچه ساختیم، باید به غیرعادی بودن بار کاری خود اعتراف کنیم. جای تعجب نیست که Anthropic از Claude برای نوشتن نرمافزار بسیار بیشتر از تقریباً هر شرکت دیگری استفاده میکند، بنابراین ما اغلب اولین کسانی هستیم که نقاط فشار ابزارهای ساخته شده برای مقیاس انسانی را تجربه میکنیم. کنترل منبع تنها یک نمونه از این موارد است. اگرچه انتظار نداریم بسیاری از سازمانها در کوتاهمدت با این مشکلات مواجه شوند، اما حدس میزنیم طول نمیکشد که سایر کاربرانی که از ابزارهای کدنویسی هوش مصنوعی استفاده میکنند نیز همین نقاط فشار را تجربه کنند، به همین دلیل خواستیم آنچه ساختیم و آموختیم را به اشتراک بگذاریم.
Git یک سیستم غیرمتمرکز است: هر کلون یک ریپوی کامل و مستقل است که میتواند دیفها (Diffs) را محاسبه کند، تاریخچه و Blame را بخواند و هر ویرایشی را کاملاً آفلاین چکاوت کند. برای اکثریت قریب به اتفاق ریپوها، این طراحی صحیح است و بخش بزرگی از دلیل استاندارد شدن Git همین است.
همانطور که مونوریپوی ما رشد میکند، کمتر در فضای این طراحی جا میگیرد. تاریخچه شاخه اصلی ما به تنهایی نزدیک به ۱۰۰ گیگابایت است و یک کپی کاری فشرده بیش از ۲۵ گیگابایت حجم دارد. ما برای CI حدود ۲۵ میلیون چکاوت کد در روز انجام میدهیم، قبل از شمارش محیطهای توسعهدهنده، سندباکسهای عامل و مشاغل تحقیقاتی. اگر به سادگی دریافت شود، این مقدار بیش از ۶۰۰ پتابایت ترافیک Git در روز خواهد بود.
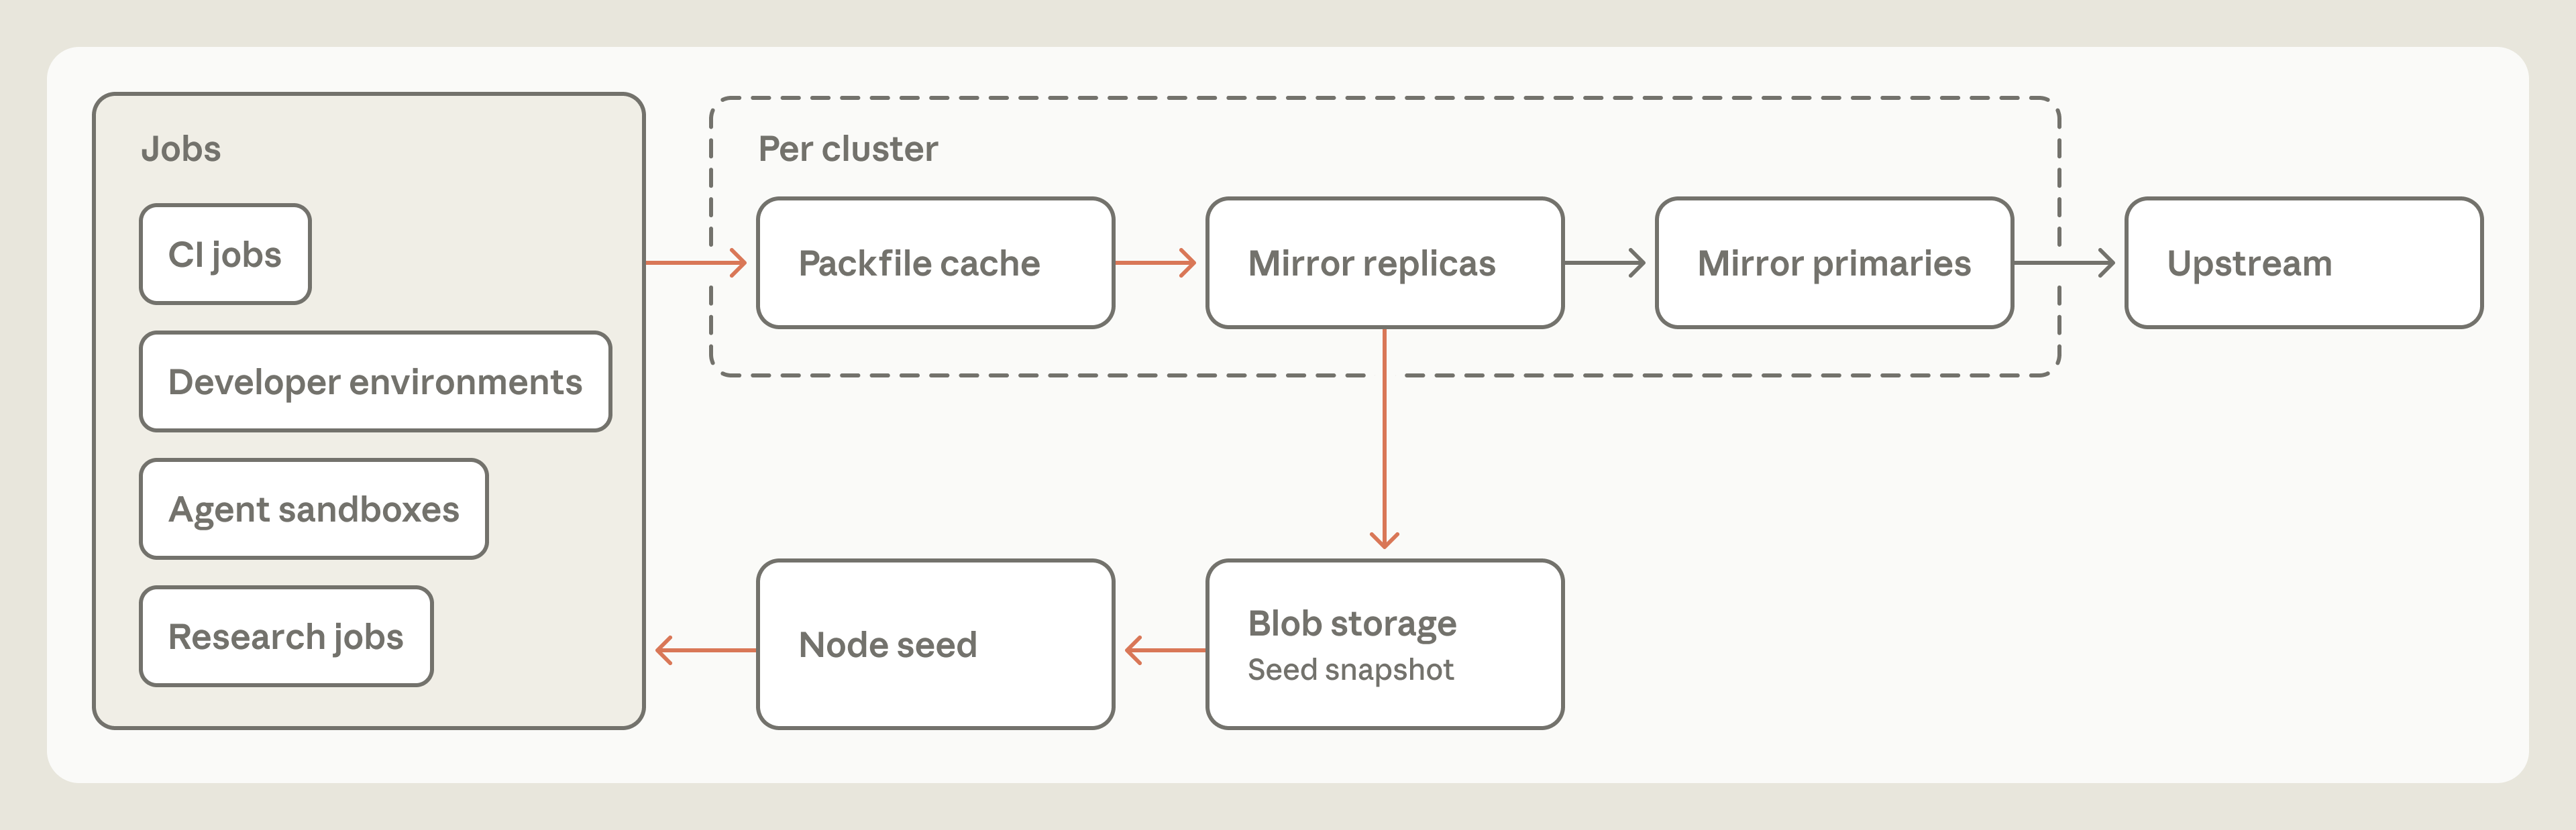
Git ابزارهایی برای کار با بخشی از یک ریپو ارائه میدهد، مانند کلونهای کمعمق (Shallow clones)، چکاوتهای پراکنده (Sparse checkouts) و ریموتهای Promisor. فراتر از اینها، راهحلهای جایگزین استانداردی برای مونوریپوهای بزرگ وجود دارد، مانند آینههای داخلی Git و اسنپشاتهای ریپو (Seeds) که در Blob storage نگهداری میشوند. ما از همه آنها استفاده کردهایم - در اوج بار، چند صد آینه داخلی Git را برای مدیریت بار عملیاتی میکردیم. این کار به ما زمان خرید، اما با افزایش نرخ ادغام، مدیریت آنها دشوارتر شد. Seeds بین بروزرسانیها از نوک شاخه اصلی دورتر میافتادند و مراقبت بیشتری لازم بود تا عملیاتی که به تاریخچه وابسته هستند، مانند diff و blame، روی کلونهای جزئی کار کنند.
با عقب رفتن یک قدم، متوجه شدیم که مانند اکثر شرکتها، از Git به عنوان یک سیستم متمرکز با یک کپی معتبر استفاده میکردیم، اما تقریباً تمام کلاینتهای ما عاملها و مشاغلی بودند که ذاتاً آنلاین هستند. ویژگیهایی که Git را برای کار توزیعشده و آفلاین عالی میکنند، عملاً توانایی ما برای مقیاسپذیری با رشد ریپو را تضعیف میکردند. بنابراین از خود پرسیدیم: اگر کنترل منبع را از ابتدا با این واقعیت که عاملها همیشه آنلاین هستند طراحی کنیم، چه شکلی خواهد داشت؟
اصول کنترل منبع در مقیاس عامل
با کدنویسی عاملمحور، بسیاری از فرضیات رایج درباره نحوه توسعه نرمافزار در حال تحول است. ما هنگام ساخت Scion این تغییرات را پذیرفتیم که به ما اجازه داد در چندین اصل اساسی، رویکردی بنیادین متفاوت از Git اتخاذ کنیم. کنترل منبع برای مونوریپوهای عظیم سابقه دارد، به ویژه Piper گوگل و Sapling متا، بنابراین توانستیم Scion را با در نظر گرفتن درسهای ارزشمند آنها بسازیم. اصول ما عبارتند از:
کلاینتها همیشه آنلاین هستند. Git فرض میکند که کلاینتها آفلاین کار میکنند و به کپی کاملی از ریپو نیاز دارند. از آنجا که تقریباً تمام کلاینتهای ما عاملها و مشاغل هستند، ما کلاینت و پروتکلهای Scion را حول سروری طراحی کردیم که همیشه قابل دسترسی است و کلاینتها دادهها را در صورت نیاز دریافت میکنند.
عدم تقارن کلاینت-سرور. در Git، هر کلاینت قابلیت تبدیل شدن به یک سرور کامل را دارد. در Scion، سرور به سوالات مربوط به تاریخچه فایل و blame پاسخ میدهد، کامیتها را ایجاد میکند، ادغامها و ریبیسها (Rebases) را انجام میدهد و غیره. کلاینت یک کش آبجکت محلی محدود را حفظ میکند، فایلهای کپی کاری را روی دیسک چیدمان میکند، تغییرات فایلسیستم را نظارت میکند و راهی ارگونومیک برای کار با سرور به کاربران میدهد. کلاینت به ندرت چیزی را خودش محاسبه میکند اما در عوض، دادههای محلی بسیار کمتری نیاز دارد.
یک سرویس جامع کنترل منبع میتواند بسیاری از کاربردهای نوآورانه را تغذیه کند. با Git، یک شغل CI یا ابزاری که نیاز به پرسیدن سوالی درباره ریپو دارد، مانند اینکه آخرین تغییر یک خط توسط چه کسی انجام شده یا دو کامیت چگونه مرتبط هستند، باید کپی محلی ریپو را حفظ کند یا امیدوار باشد APIهای خاص فروشنده پاسخ را ارائه دهند. با Scion، تمام کوئریهای کنترل منبع که کلاینت استفاده میکند از طریق API نیز در دسترس هستند، بنابراین در بسیاری از موارد مشاغل اصلاً به ریپوی محلی نیاز ندارند. بسیاری از ابزارهای داخلی، مانند خطوط لوله خودکار Bisect و Revert ما، بدون این دسترسی ارزان و برنامهریزیشده به کنترل منبع در مقیاس بالا عملی نخواهند بود.
همه چیز باید افقی مقیاسپذیر باشد. در اوج بار، چند صد آینه Git اجرا میکردیم که ظرفیت را به شدت تحت فشار قرار میداد و پس از اینکه ریپو از محدودیتهای دیسک یا حافظه آینهها فراتر رفت، دیگر مقیاسپذیر نبود. در Scion، دادههای ریپو توزیع شدهاند و هر جزء به طور مستقل مقیاسپذیر است؛ هیچ کپی کاملاً مادیشده از ریپو در هیچ کجا، حتی روی سرور، وجود ندارد. معادلی برای Packfiles (بستههای فشرده آبجکتها در Git) وجود ندارد، بنابراین هیچ نگهداری ریپویی لازم نیست.
کامیتها باید ارزان، افزاینده و بدون قفل باشند. در Git، شما به صورت محلی کامیت میکنید و سپس برای اشتراکگذاری کارتان Push میکنید. در Scion، هر کامیت، ریبیس یا ادغام روی سرور رخ میدهد، بنابراین چیزی برای Push کردن وجود ندارد، اما هر یک از این عملیاتها باید سریع باشند. هزینه ایجاد یک کامیت و بهروزرسانی ساختارهای داده پاییندستی آن باید با اندازه تغییر مقیاس پیدا کند، نه با اندازه کلی ریپو، وگرنه سرور نمیتواند هماهنگ بماند. چرخه عمر توسعه در Scion از Refs (اشارهگرهایی به کامیتها مانند شاخهها و تگها) جلوگیری میکند، به جز Ref اصلی یا شاخههای انتشار، زیرا وضعیت جهانی که هر سروری باید روی آن توافق کند، یک مشکل مقیاسپذیری بالقوه است.
کپی کاری اختیاری است و به طور ذاتی پراکنده طراحی شده است. چون مونوریپوی ما بسیار بزرگ است و ما دهها میلیون بار در روز برای CI کد را چکاوت میکنیم، میخواستیم تا حد ممکن از چکاوتها اجتناب کنیم. با Scion، یک شغل CI که نیاز به دیف بین یک کامیت و Merge Base آن دارد، میتواند آن را از سرور درخواست کند. همین امر برای نوشتنها نیز صادق است: بسیاری از بارهای نوشتن میتوانند چکاوت را نادیده بگیرند و کاملاً از طریق API کار کنند. پروتکل Scion حول چکاوتهای پراکنده متمرکز است که فقط شامل دایرکتوریهایی هستند که کلاینت درخواست میکند، و چکاوتهای مجازیسازیشده که فایلها را در صورت تقاضا مادیسازی میکنند، بنابراین وقتی یک شغل واقعاً به فایلها روی دیسک نیاز دارد، کلاینت فقط برای آنچه واقعاً میخواند هزینه پرداخت میکند.
نحوه عملکرد Scion
درک اینکه چگونه این اصول در عمل هنگام ساخت Scion کنار هم جمع شدند مفید است. این بینشها میتوانند برای سایر سیستمهای کنترل منبع یا به طور کلیتر، برای سایر مراحل چرخه عمر توسعه نرمافزار اعمال شوند.
ساختارهای داده
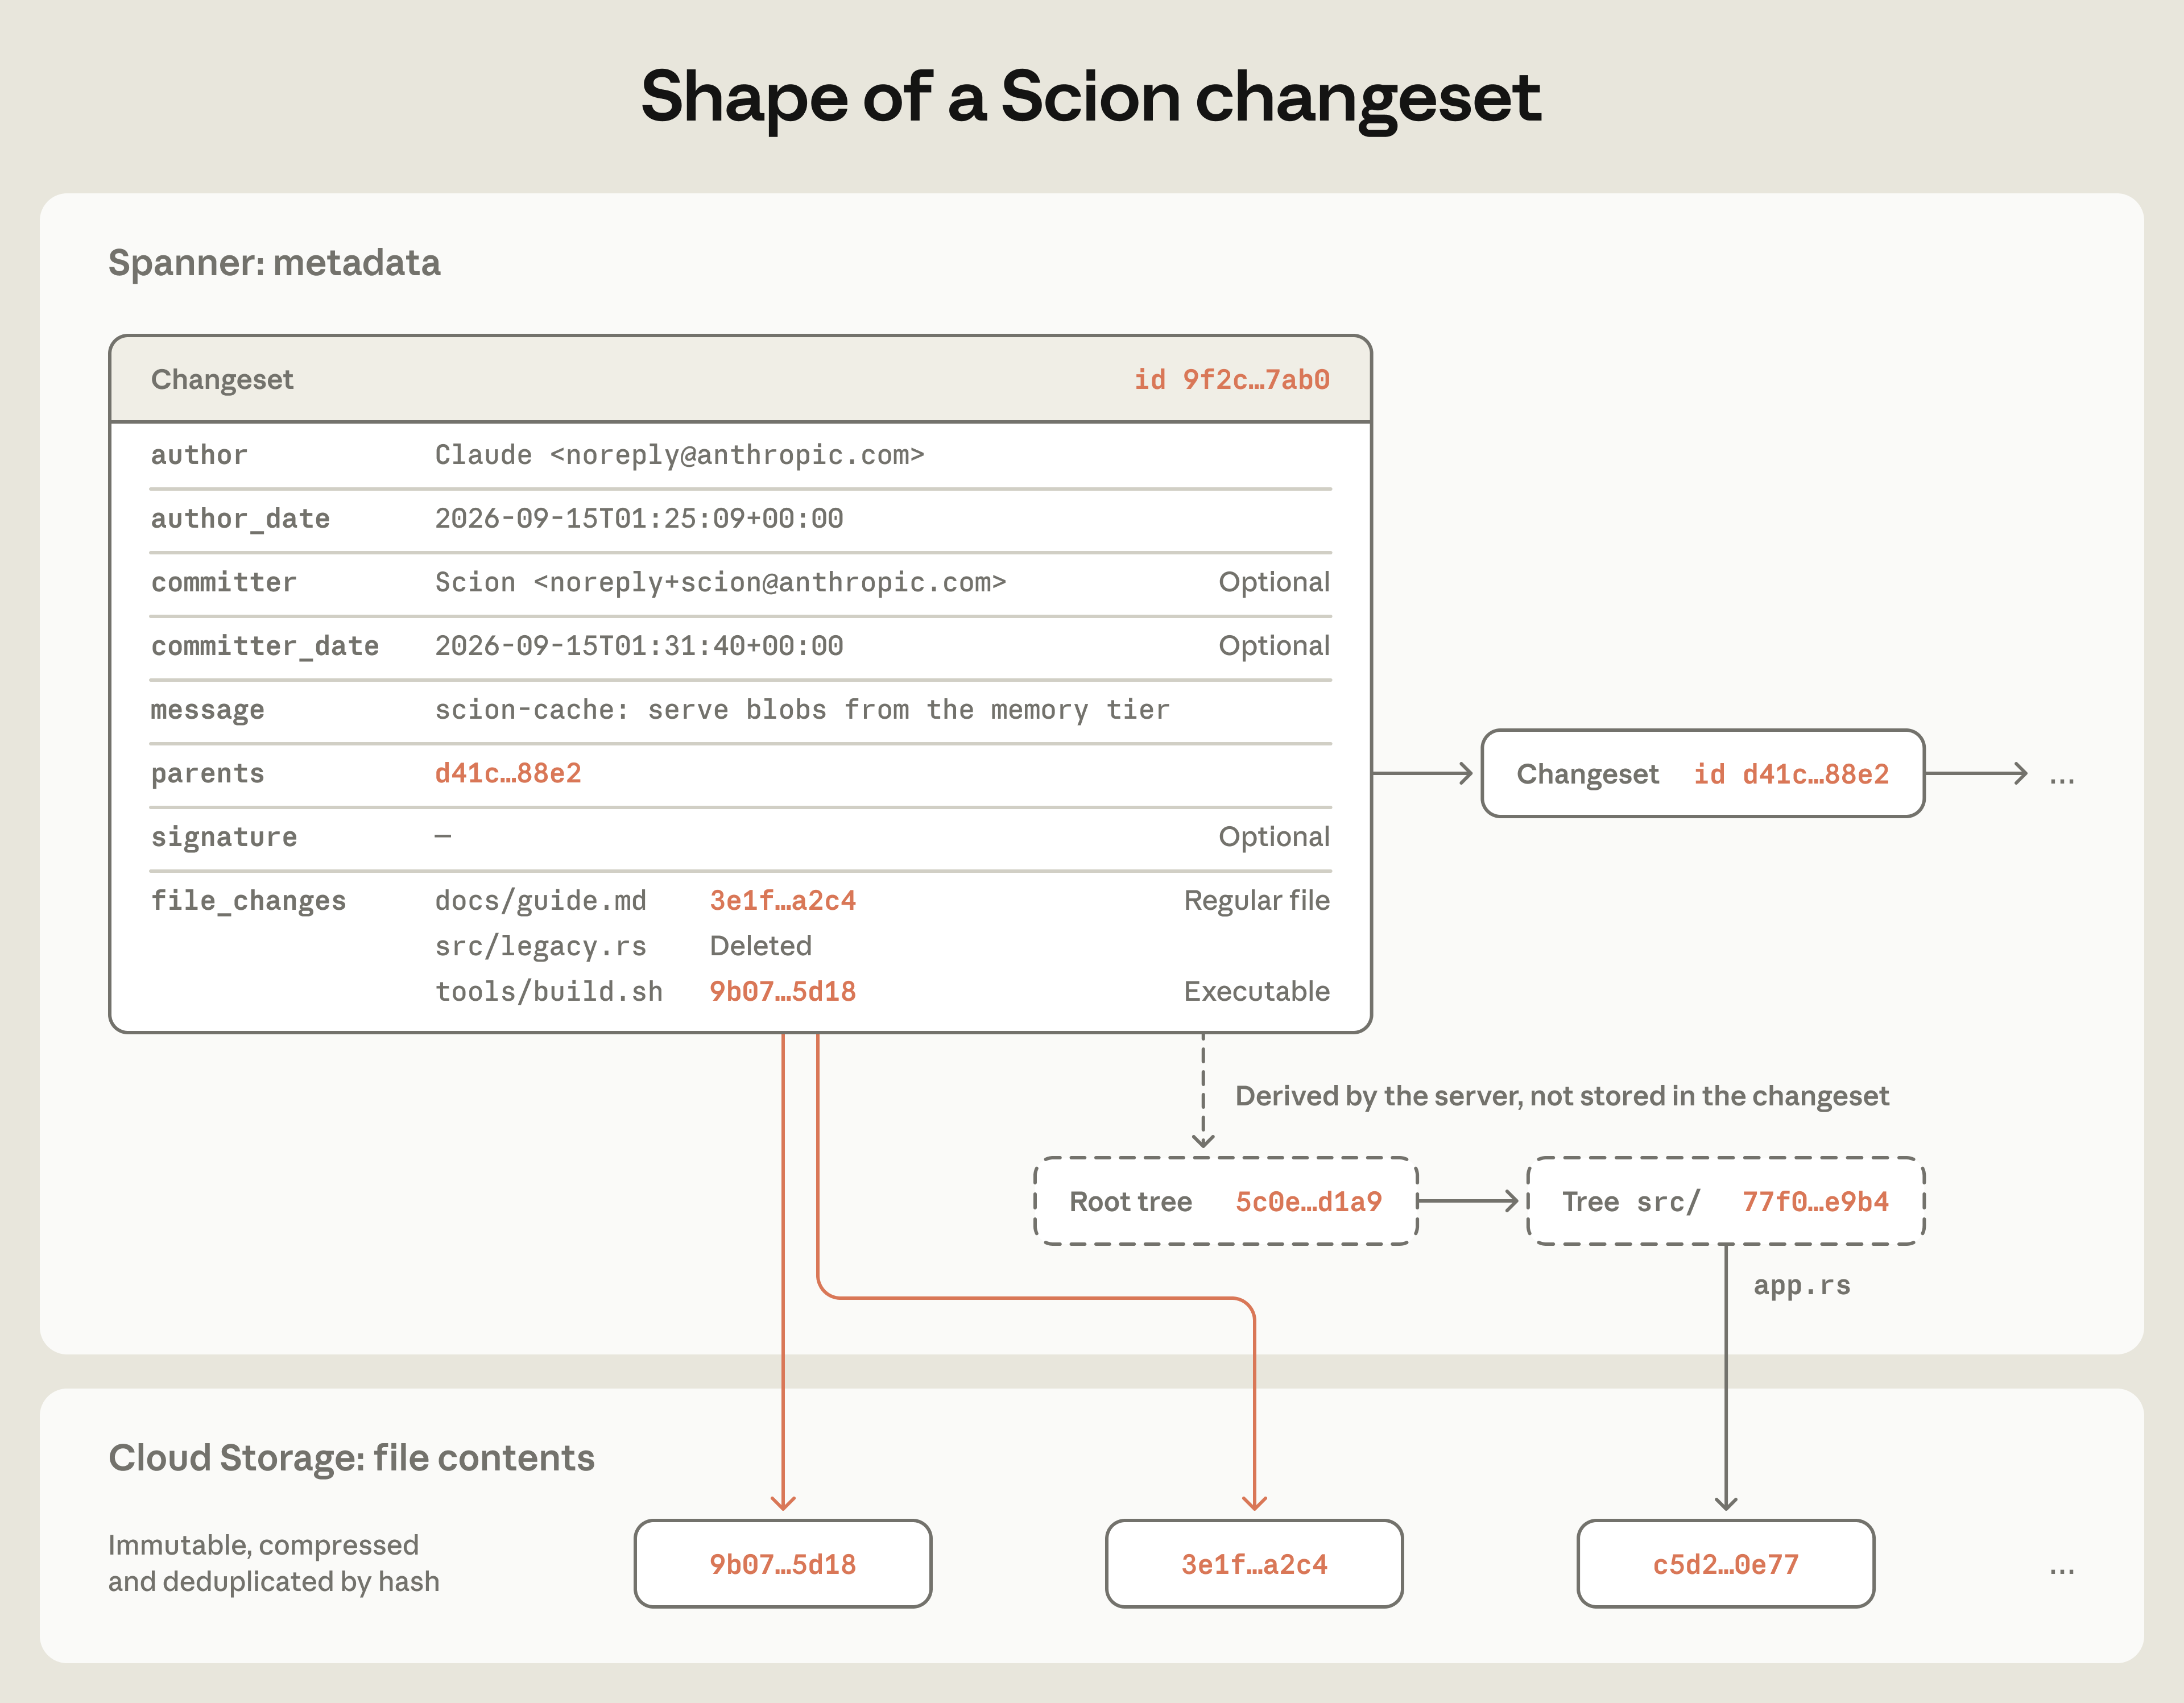
در Scion، واحد کار یک "Changeset" است، یک ورودی در Write-ahead log. یک Changeset بیشتر آنچه را که از یک کامیت در Git انتظار دارید ذخیره میکند. اما جایی که یک کامیت Git اشارهگری به درخت (Tree) ذخیره میکند، یک Changeset لیستی از فایلهایی که نسبت به والد اول خود تغییر کردهاند را همراه با اشارهگرهای Content-addressed به محتوای فشرده فایلها در Blob storage ذخیره میکند. Changesetها سمت سرور ایجاد میشوند و فوراً در همه جا در دسترس هستند.
این ساختار به ما امکان میدهد Changesetها را با ازدهی بسیار بالا بپذیریم، زیرا هیچ Packfile برای پذیرش وجود ندارد، هیچ قفل یا هماهنگی بین سرورها لازم نیست و هیچ Refی برای جابهجایی وجود ندارد. Scion به طور فنی از Refs پشتیبانی میکند، اما از آنجا که نه ایجاد و نه دریافت کامیتها درگیر آنها نیست، جابهجایی یکی از آنها یک عملیات Compare-and-swap روی یک ردیف Spanner است که جدا از ایجاد Changesetها رخ میدهد.
یک Changeset فقط آنچه تغییر کرده را ثبت میکند، بنابراین به تنهایی نمیتواند به سرعت به سوالاتی مانند اینکه آخرین ویرایش یک خط توسط چه کسی انجام شده یا کدام کامیتها روی یک فایل تأثیر گذاشتهاند پاسخ دهد. برای پاسخ به این سوالات، Scion ساختارهای داده اضافی از Changesetها میسازد، شامل ساختارهای اختصاصی برای Blame فایل و تاریخچه مسیر و Skip lists برای گراف کامیت. ما به هر چیزی که مستقیماً بخشی از Changeset نباشد "داده مشتقشده" میگوییم و همه آنها را از طریق یک مکانیزم عمومی محاسبه میکنیم. هر نوع داده مشتقشده به صورت بازگشتی تعریف میشود، بنابراین مقدار آن برای یک Changeset از مقادیر آن برای والدین آن Changeset محاسبه میشود.
این مکانیزم سه مزیت دارد. اول، میتوانیم به راحتی یک نوع جدید داده مشتقشده اضافه کنیم وقتی یک ساختار داده جدید باعث میشود برخی عملیاتها سریعتر شوند. دوم، برای هر نوع، میتوانیم انتخاب کنیم که آیا آن را eagerly محاسبه کنیم یا کار را به تعویق بیندازیم، بنابراین از مادیسازی دادههایی که به آنها نیاز نداریم اجتناب میکنیم. سوم، از آنجا که کلاینت هرگز جزئیات داخلی این ساختارهای داده را نمیبیند، میتوانیم آنها را بدون تغییر کلاینت بهینه کنیم. ما بارها انواع جدیدی از دادههای مشتقشده را با رشد سیستم اضافه کردهایم، مانند شاخصهای جدید برای انجام تشخیص کپی یا جستجوی فایل مبتنی بر مسیر.
مقیاسپذیری Scion
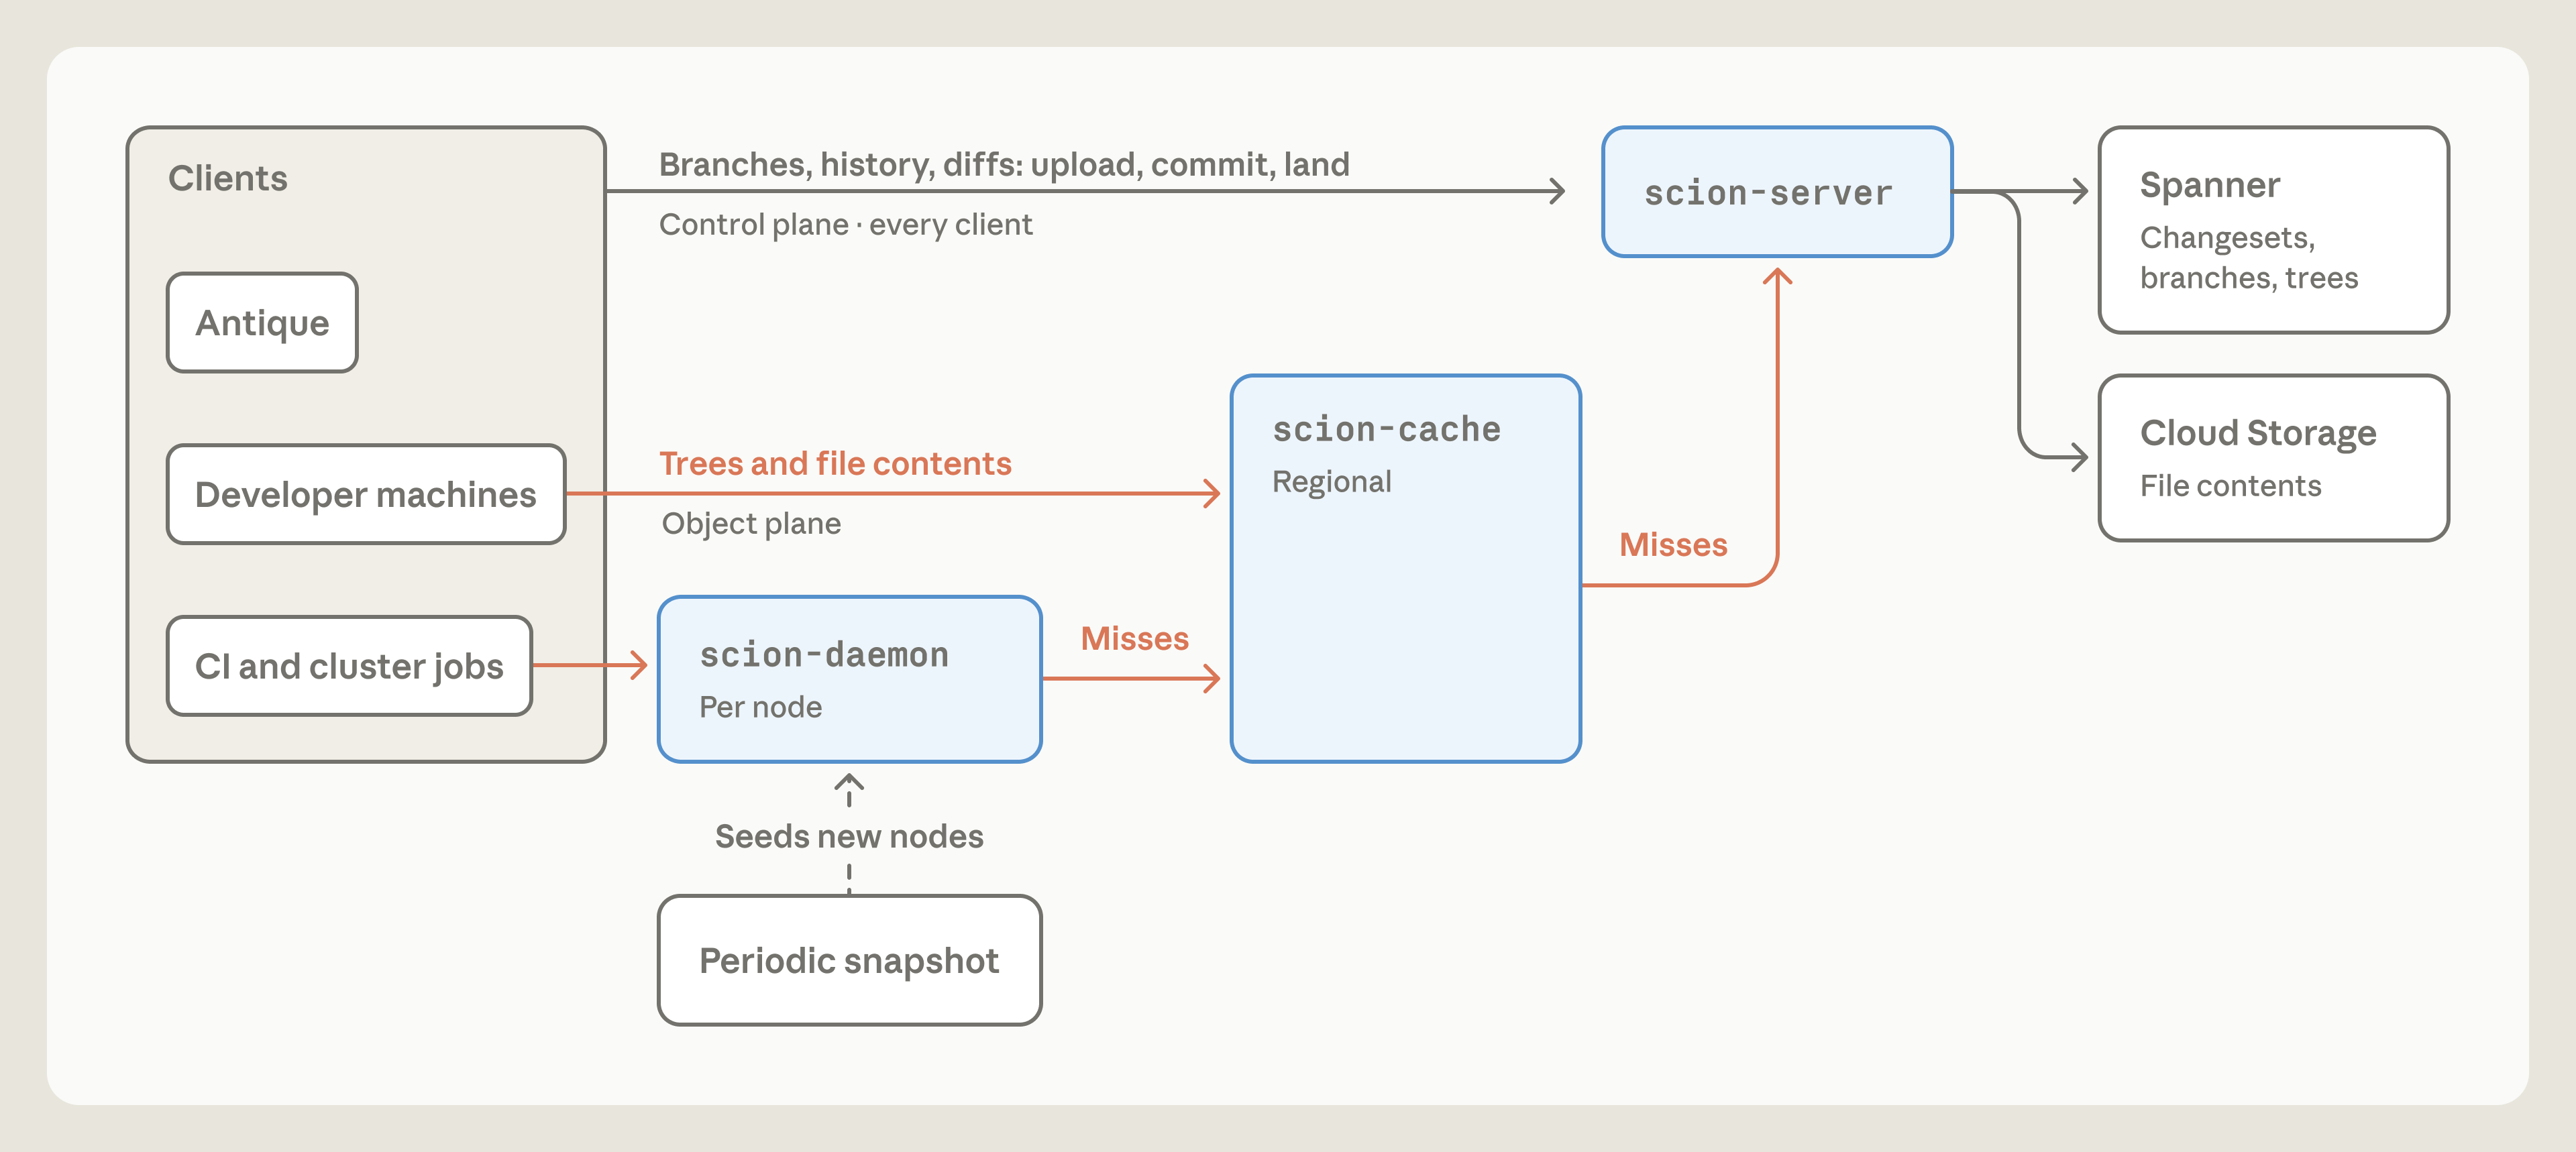
یک ناوگان کوچک از سرورهای Scion APIهای کنترل منبع را برای هر عملیاتی که کلاینت نیاز دارد، مانند دریافت Changesetها، محاسبه دیفها، یافتن Merge baseها و دریافت Blobها، فراهم میکند. تمام دادههای کنترل منبع Content-addressed هستند، بنابراین یک قطعه داده پس از ذخیره هرگز تغییر نمیکند و هر سروری میتواند آن را بدون هماهنگی با دیگران کش کند. در نتیجه، سرورها افقی مقیاسپذیر هستند و به هماهنگی کمی نیاز دارند. آنها اساساً کشهای بزرگی هستند که همچنین میتوانند دادههای مشتقشده را به صورت آنی محاسبه کرده و نتایج را در Spanner بنویسند.
مصرفکنندگان متعدد Scion دیگر نیازی به حفظ ریپوهای محلی خود ندارند. دریافت و نگهداری ریپو قبلاً یک بار نگهداری قابل توجه برای مشاغل CI یا ابزارهایی بود که نیاز به پرسیدن سوالات کنترل منبع داشتند، به ویژه درباره نسب کامیت و Blame. در اوایل مهاجرت، قبل از اینکه کلاینت، فرمت ریپو یا پروتکلهای خودمان را داشته باشیم، Scion فقط به این کوئریهای "متادیتا" پاسخ میداد. دریافت محتوای فایل و مادیسازی کپیهای کاری عملیاتهای بسیار دادهمحورتری هستند و به طراحی خاص خود نیاز داشتند.
کلاینت scn Scion از پروتکلهای دریافت Git در چندین جهت مهم منحرف میشود و در نتیجه، به یک معماری بسیار مقیاسپذیر منجر میشود که به CPU بسیار کمتری نسبت به سرورهای Git نیاز دارد. مذاکره Scion به سرور نمیگوید کلاینت چه چیزی را از قبل دارد؛ بلکه منحصراً روی Treeها و Blobهایی که کلاینت میخواهد عمل میکند. کلاینت با شروع از یک Root tree، فروشگاه محلی خود را برای Treeهای گمشده بررسی و آنها را به صورت بازگشتی درخواست میکند، سپس این فرآیند را برای Blobها تکرار میکند. هر درخواست برای یک آبجکت خاص است که هرگز تغییر نمیکند، بنابراین هر کشی میتواند به آن پاسخ دهد و معماری شباهت نزدیکی به کشهای لایهای سنتی دارد. این فرآیند همچنین کارآمد و قابل ازسرگیری است، زیرا هیچ پاسخ Packfile چند گیگابایتی واحد وجود ندارد. چکاوتهای پراکنده و حتی مجازیسازیشده به پشتیبانی خاصی نیاز ندارند، زیرا کلاینت به سادگی Treeهایی که نمیخواهد را درخواست نمیکند.
در ناوگان، کلاینت از طریق سوکت با یک Daemon به نام scion-daemon صحبت میکند که آبجکتها را برای کل نود ذخیره میکند. اکثر نودهای ما به دسترسی به مونوریپو نیاز دارند و مشاغل روی همان نود بیشتر آبجکتهای مشابه را دوباره استفاده میکنند. هر Daemon از یک اسنپشات که دورهای بروزرسانی میشود شروع میکند، سپس فقط با سرورهای کش Tree و Blob در منطقه خود که scion-cache نامیده میشوند صحبت میکند. این سرورهای کش آبجکتها را مستقیماً از حافظه، در فرمت دیسکی که Daemon مصرف خواهد کرد، جریان میدهند، بنابراین نیازی به صرف زمان برای محاسبه آبجکتهای گمشده کلاینت یا انجام فشردهسازی دلتا ندارند. وقتی یک کش آبجکتی را ندارد، از scion-serverهای معتبر میپرسد که در صورت نیاز از Spanner یا Cloud storage میخوانند.
scion-daemon، scion-cache و scion-server همه به RPCهای یکسان برای این پروتکل پاسخ میدهند، بنابراین کلاینت نیازی به دانستن توپولوژی کش ندارد. هر لایه ای به طور نظری میتواند با هر لایه دیگری صحبت کند، اما ما لایهبندی را به شدت اعمال میکنیم تا دامنههای خرابی را ایزوله کنیم. ما میخواهیم از موقعیتی اجتناب کنیم که خرابی در یک scion-cache منطقهای سرورهای بالادستی scion-server را تحت فشار قرار دهد و کل سیستم را از کار بیندازد.
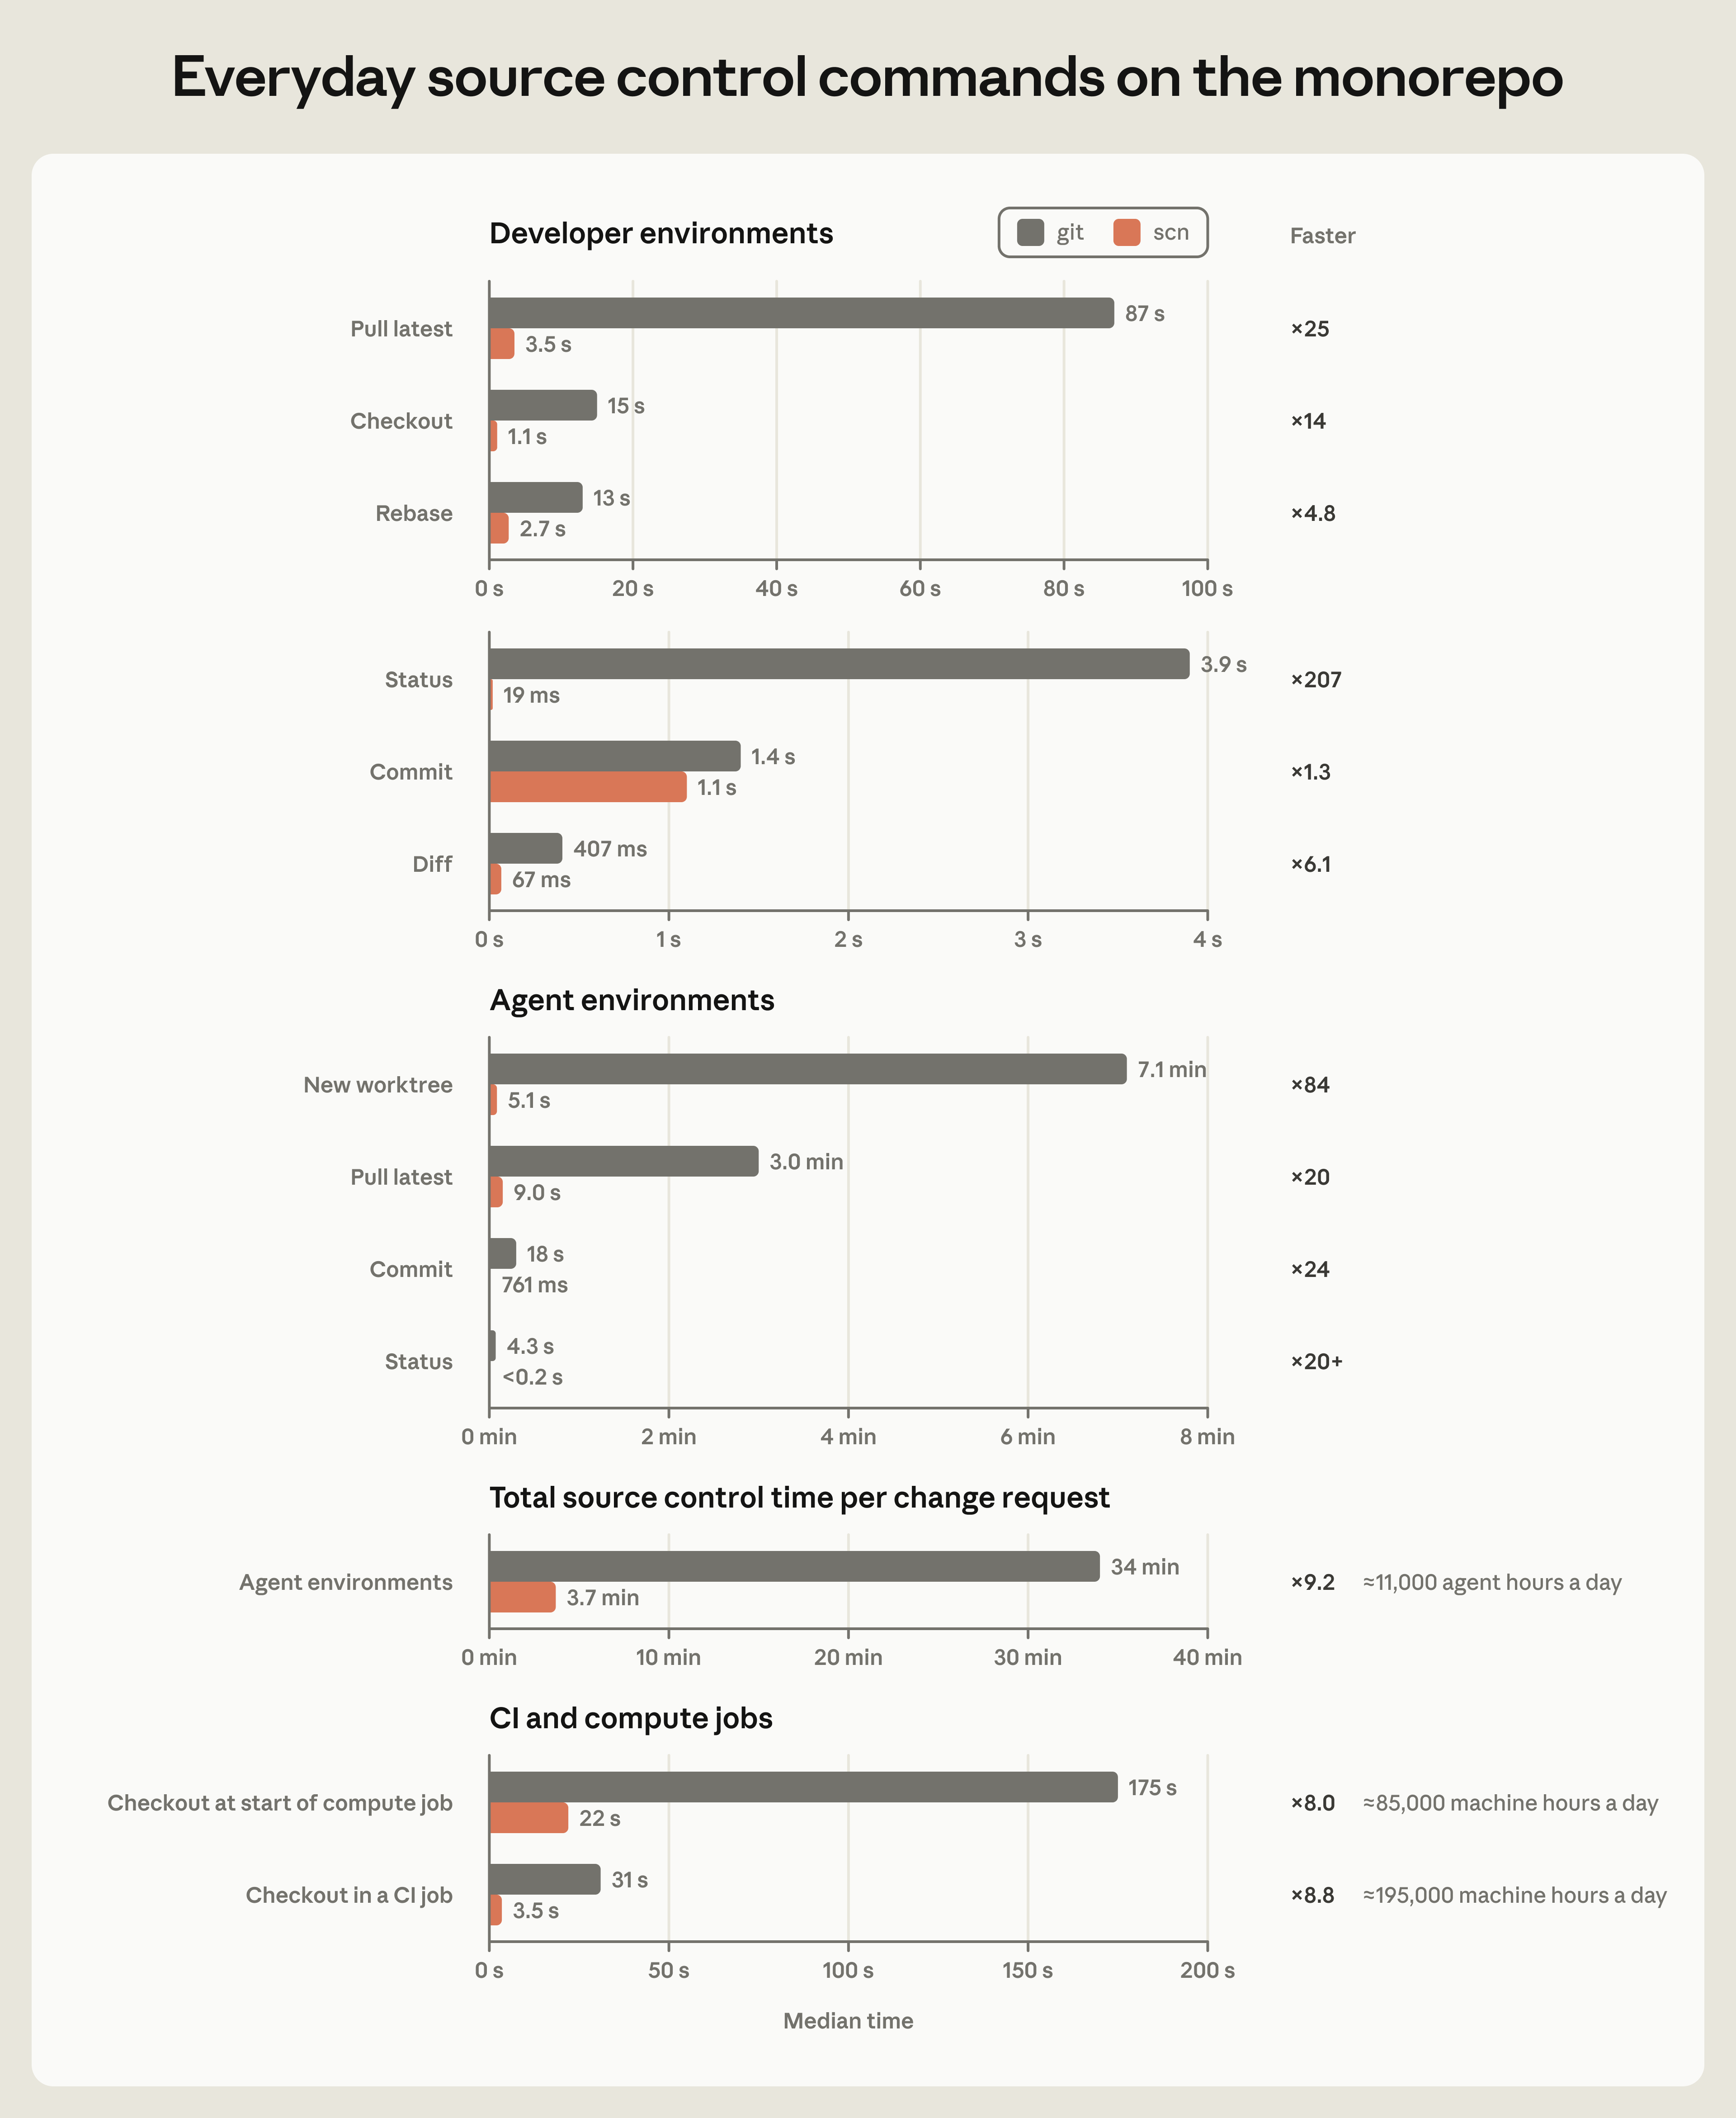
هر لایه از این سیستم نرخ اصابت کش بیش از ۹۹٪ را حفظ میکند و به وضعیت بلندمدت نیاز ندارد، بنابراین در صورت نیاز به راحتی مقیاسپذیر است. ردپای زیرساخت Scion ما اکنون از نظر نیازهای CPU و حافظه ۲۰۰ برابر کوچکتر از زیرساخت آینهسازی Git قبلی ما است. مشاغل CI و تحقیقاتی کد را دو مرتبه بزرگی سریعتر چکاوت میکنند (در ثانیه به جای دقیقه)، که مقدار قابل توجهی ظرفیت را در سراسر ناوگان آزاد میکند؛ CI به تنهایی ۲۵ درصد سود ظرفیت CPU کسب کرد. نه کلاینتها و نه کشها نیازی به انجام نگهداری ریپو ندارند، که مدیریت چرخه عمر مشاغل ما را سادهتر میکند.
آنچه از ساخت Scion آموختیم
ما تقریباً همزمان با در دسترس شدن داخلی Claude Mythos Preview و Claude Tag شروع به ساخت Scion کردیم. هر دو از این انتشارات همزمان نیاز به Scion را تشدید کردند و سرعت ساخت آن را به طور معناداری افزایش دادند.
اینجا یک مثال به ویژه چشمگیر است. در اوایل سال، ما نسخه اولیه خط لوله دریافت Git-to-Scion را عمدتاً به صورت دستی به عنوان یک نمونه اولیه نوشته بودیم. فکر میکردیم خوب است - تا زمانی که به یک اسنپشات داخلی اولیه از Claude Mythos Preview دسترسی پیدا کردیم. از آن خواستیم کل آن را بازنویسی کند و بدون دستورالعمل بیشتر، نسخهای تولید کرد که ۲۰ برابر حافظه کمتری مصرف میکرد و ۴ برابر سریعتر بود، در حالی که تمام ثابتهای ضمنی حول ترتیب دریافت و ساختارهای داده را حفظ کرد.
آنچه از ساخت و بهرهبرداری Scion آموختیم، درسهای جالبی برای آنچه ساخت نرمافزار در مقیاس عامل میتواند باشد ارائه میدهد.
توسعه سریع با تیم کوچک رایجتر خواهد شد. یک تیم هفت نفره هم Scion و Antique (ابزار بازبینی کد ما که میتوانستیم درباره آن یک پست وبلاگ کامل بنویسیم) را ساخت، به علاوه نیم دوجین سیستم مرتبط، و در پنج ماه به طور کامل به آنها مهاجرت کرد. ما تمام این کارها را در حالی انجام دادیم که حجم کد ادغامشده در روز ۱۰ برابر افزایش یافته بود. در گذشته، توسعه و استقرار چنین سیستم کنترل منبعی سالها مهاجرت تکراری با مهندسان بسیار بیشتر را برای یک شرکت نیاز داشت. ما فکر میکنیم این نوع مهاجرت سریع و چابک در آینده رایجتر خواهد شد.
مهندسان کمارزشتر نشدهاند، اما کارشان تغییر کرده است. تمام مهندسانی که روی این سیستم کار کردند اکنون Claude را در نوشتن کد بهتر از خود ارزیابی میکنند. اما مهندسان ما همچنان درک بیبدیل از اجزای بینسیستمی سطح بالا و مبادلات طراحی را ارائه دادند و در مورد مشکلاتی که میخواستیم حل کنیم و مقیاسی که میدانستیم باید به آن برسیم، انتخابهای آگاهانه انجام دادند. اغلب دیدیم که نقش مهندسان گفتن "نه" به Claude بود. عاملها گاهی اوقات برای ارضای الگویی که نباید از ابتدا مجاز بوده، محدودیتهای اصلی سیستم را نقض میکنند. این موضوع به ویژه در مهاجرت ما رایج بود. برای مثال، چندین سیستم تلاش کردند با خواندن خطی لاگ کامیت به جای پرسیدن از ابزار بازبینی کد ما، زمان ادغام تغییرات به شاخه اصلی را به صورت زورکی پیدا کنند. Anthropic همچنین به طور گسترده از بازبینی خصمانه استفاده میکند و اگرچه این روش از جهات مختلف بسیار موثر است، اما میتواند کوتهبینانه نیز باشد، بنابراین مهندسان ماهر نیاز داشتند Claude را از بیشطراحی بخشهایی از سیستم در پاسخ به نگرانیهای فرضی دور نگه دارند. برای مثال، یکی از این بازبینیها نسبت به اعتماد به یک سرویس داخلی دیگر بیش از حد تدافعی بود، که منجر به افزودن اعتبارسنجی و پیچیدگی بیش از حد توسط Claude شد. اعضای تیم ما همچنان هر درخواست تغییر برای سیستم را بازبینی میکنند، اما اکنون قصد تغییر را بررسی میکنند به جای خواندن هر خط کد.
ما توانستیم بهینهسازی و کیفیت را به طور قابل توجهی بهبود بخشیم. به واسطه توانایی Claude در نوشتن حجم عظیمی از کد با سرعتی بسیار بیشتر از خودمان، Scion یکی از بهترین تستشدهترین و دفاعشدهترین پایگاههای کدی است که تاکنون روی آن کار کردهایم. حتی با جدول زمانی فشرده ما، توانستیم شبیهسازیهای Hermetic از هر تعامل غیربدیهی زیرساخت و کنترل منبع که تاکنون با آن مواجه شدهایم، به همراه Fuzzing و محدودسازی نرخ پیشرفته بسازیم. Claude همچنین به راحتی بهینهسازیهای قابل توجهی پیدا کرد - برای مثال، یک بهینهسازی الگوریتمی برای کوئریهای نسب که یکی از شاخصهای ما را از دست داده بود - که تحلیل و تنظیم آن روزها یا هفتهها برای یک متخصص طول میکشید... و سپس فردای آن روز دوباره همان کار را انجام داد.
ما زمینه را برای اشکال جدیدی از امنیت مونوریپو فراهم کردیم. مدیریت ایمنی، امنیت و انطباق در یک مونوریپوی عظیم به اندازه مدیریت اندازه و مقیاس اهمیت دارد. ما Scion را از ابتدا با در نظر گرفتن این موارد ساختیم. این سیستم از کنترل دسترسی غنی روی ریپوها و همچنین قابلیت اعمال مجوزها به دایرکتوریهای فردی برای محافظت از حساسترین کدها بدون از دست دادن مزایای مونوریپو پشتیبانی میکند. علاوه بر این، ابزارهای بازبینی کدی که ساختیم میتوانند محدودیتهای معنایی پیچیدهای را روی تاییدها بیان کنند، که به ما اجازه میدهد تغییرات ساده مانند تغییرات فقط کامنت را از تغییرات منطقی حساس متمایز کنیم، تا بازبینان انسانی بتوانند روی مهمترین تغییرات تمرکز کنند.
سطح جدیدی از تعالی عملیاتی ممکن است. تیم ما به شدت از Claude Tag استفاده میکند که به ما کمک کرده هر جزء از سیستم را نظارت کنیم. برای مثال، کانالهای Slack ایجاد کردیم که در آنها به Claude وظیفه دادیم وسواسگونه روی سلامت یک جزء واحد تمرکز کند. ما به این Claudeها "Superfans" میگوییم. ما یک Superfan برای scion-daemon، یک Superfan برای scion-cache، یک Superfan برای صف ادغام Antique و غیره داریم. آنها به تلمتری و لاگهای ما دسترسی دارند و مانند یک مهندس باتجربه عمل میکنند که کار بهتری از تازه کردن نمودارها و جستجوی هر چیز عجیب ندارد. ما همچنین هشدارهای سنتی برای تمام سیستمهای خود داریم، اما Superfans ما میتوانند مسائل ظریف و جدیدی را شناسایی کنند که در مقایسه با آنها، هشدارهای موجود تکبعدی به نظر میرسند.
ما پیشفرضهای خود را کاملاً بازنگری میکنیم. این پروژه ما را واداشت تا نگاهی بسیار دقیق به سایر جریانهای کاری طراحی شده برای مقیاس انسانی بیندازیم. یک صف ادغام مناسب، برای مثال، در مقیاس عامل چندان منطقی نیست. وقتی صدها یا حتی هزاران تغییر میتوانند در حالی که تستها در حال اجرا هستند ادغام شوند، CI اصلاً چه معنایی دارد؟ ما نتوانستهایم استاندارد صنعتی قفل جهانی ریپو روی صف ادغام را به طور موثر تکرار کنیم، بنابراین به جای آن، روی تستهای خودکار پس از ادغام و قبل از استقرار سرمایهگذاری کردهایم. این بدان معناست که تغییرات همزمان میتوانند تضاد داشته باشند، اما Claude معمولاً میتواند این تضادها را سریعتر از شناسایی آنها توسط انسانها برطرف کند.
مشارکت در اکوسیستم گستردهتر
ما Scion را تنها بخشی از پاسخ به نگرانیهای مقیاسپذیری میدانیم که عاملهای هوش مصنوعی با تواناییهای رو به افزایش مطرح کردهاند. ما این جزئیات را به عنوان مثالی از نحوه برخورد تیمها با چالشهای مشابه به اشتراک میگذاریم، هرچند انتظار نداریم راهحل ما یا ملاحظات ما برای هر موردی مناسب باشد.
Scion به هیچ وجه جایگزین مناسبی برای Git برای استفاده عمومی نیست. مفاهیمی که در اینجا طرحریزی کردیم واقعاً فقط برای مونوریپوهای بسیار عظیم، با دهها هزار مهندس یا دستههای پرکار عاملها که کد مینویسند، منطقی هستند. علاوه بر این، Anthropic به این دلیل منحصربهفرد است که توانایی ما در خرج کردن Tokenها برای استفاده داخلی بسیار فراتر از چیزی است که هر کسبوکار دیگری واقعاً تمایل به خرج کردن آن دارد. ما این کار را هم برای رفع نیازهای توسعه نرمافزار خودمان و هم برای آزمایش قابلیتهای Claude انجام میدهیم.
از نظر عملی، ارائه Scion به شکلی که برای سایر سازمانها به طور گسترده مفید باشد دشوار است. این سیستم به شدت از Git منحرف میشود، به این معنی که شرکتها باید هر قطعه از چرخه عمر توسعه را مهاجرت دهند و به بازبینی کد، جستجوی کد و CI مخصوص خود نیاز دارد. نسخههای داخلی ما از این اجزا بسیار سفارشی هستند، بنابراین پذیرش آنها برای سایر سازمانها دشوار خواهد بود و ما نگرانیم که تلاش برای ساخت یک نسخه عمومی که سعی دارد همه را راضی کند، در واقع چندان مفید نخواهد بود.
با این حال، ما پیشبینی میکنیم که این دسته از مشکلات در شش تا دوازده ماه آینده رایجتر خواهد شد و استفاده ناکارآمد از منابع مهندسی برای هر شرکتی که از Git استفاده میکند و به تنهایی با چالشهای مشابه مواجه میشود، وجود خواهد داشت. با توجه به این موضوع، ما فکر میکنیم تاثیرگذارترین کاری که میتوانیم انجام دهیم اشتراکگذاری تفکر ما است، تا سایر توسعهدهندگان بتوانند موفقترین بخشهای Scion را به Git اعمال کنند بدون اینکه از مدل کلی خارج شوند. یک سرور Git لازم نیست همان روشی را که یک کلاینت Git کار میکند دنبال کند؛ معماریهای سرور جدیدی وجود دارند که بهبودهای مقیاسپذیری قابل توجهی ارائه میدهند. پلتفرمهای Git میتوانند RPCهای جامع سمت سرور مانند Scion را ارائه دهند، شاید حتی به روشی استاندارد در سراسر Forges که کلاینت Git یاد بگیرد با آنها صحبت کند. پروتکل مذاکره نیز لازم نیست دقیقاً شبیه امروز باشد و ویژگیهای مختلف پراکنده و کمعمق در Git میتوانند به خوبی ترکیب شوند.
در نهایت، میخواهیم اذعان کنیم که جامعه Git تقریباً دو دهه را صرف مقیاسپذیری پلتفرم برای میلیونها توسعهدهنده کرده است. مشارکت ما بسیار محدودتر است: اشتراکگذاری دیدگاه اولیه ما درباره اینکه توسعه نرمافزار عاملمحور چگونه با این سیستمها تعامل دارد، تا بتوانیم با GitHub، GitLab و جامعه OSS برای حمایت از نیازهای در حال تغییر توسعهدهندگان همکاری کنیم. همه ما در این مسیر مشترک هستیم زیرا چرخه عمر توسعه نرمافزار با نمایی هوش مصنوعی تلاقی میکند.
تشکر و قدردانی
نوشته شده توسط نیک جی. و تیم کنترل منبع: اس. جی.، آر. کی.، دن سی.، گرت اچ.، بن ال.، کالین ام. و جو پی.